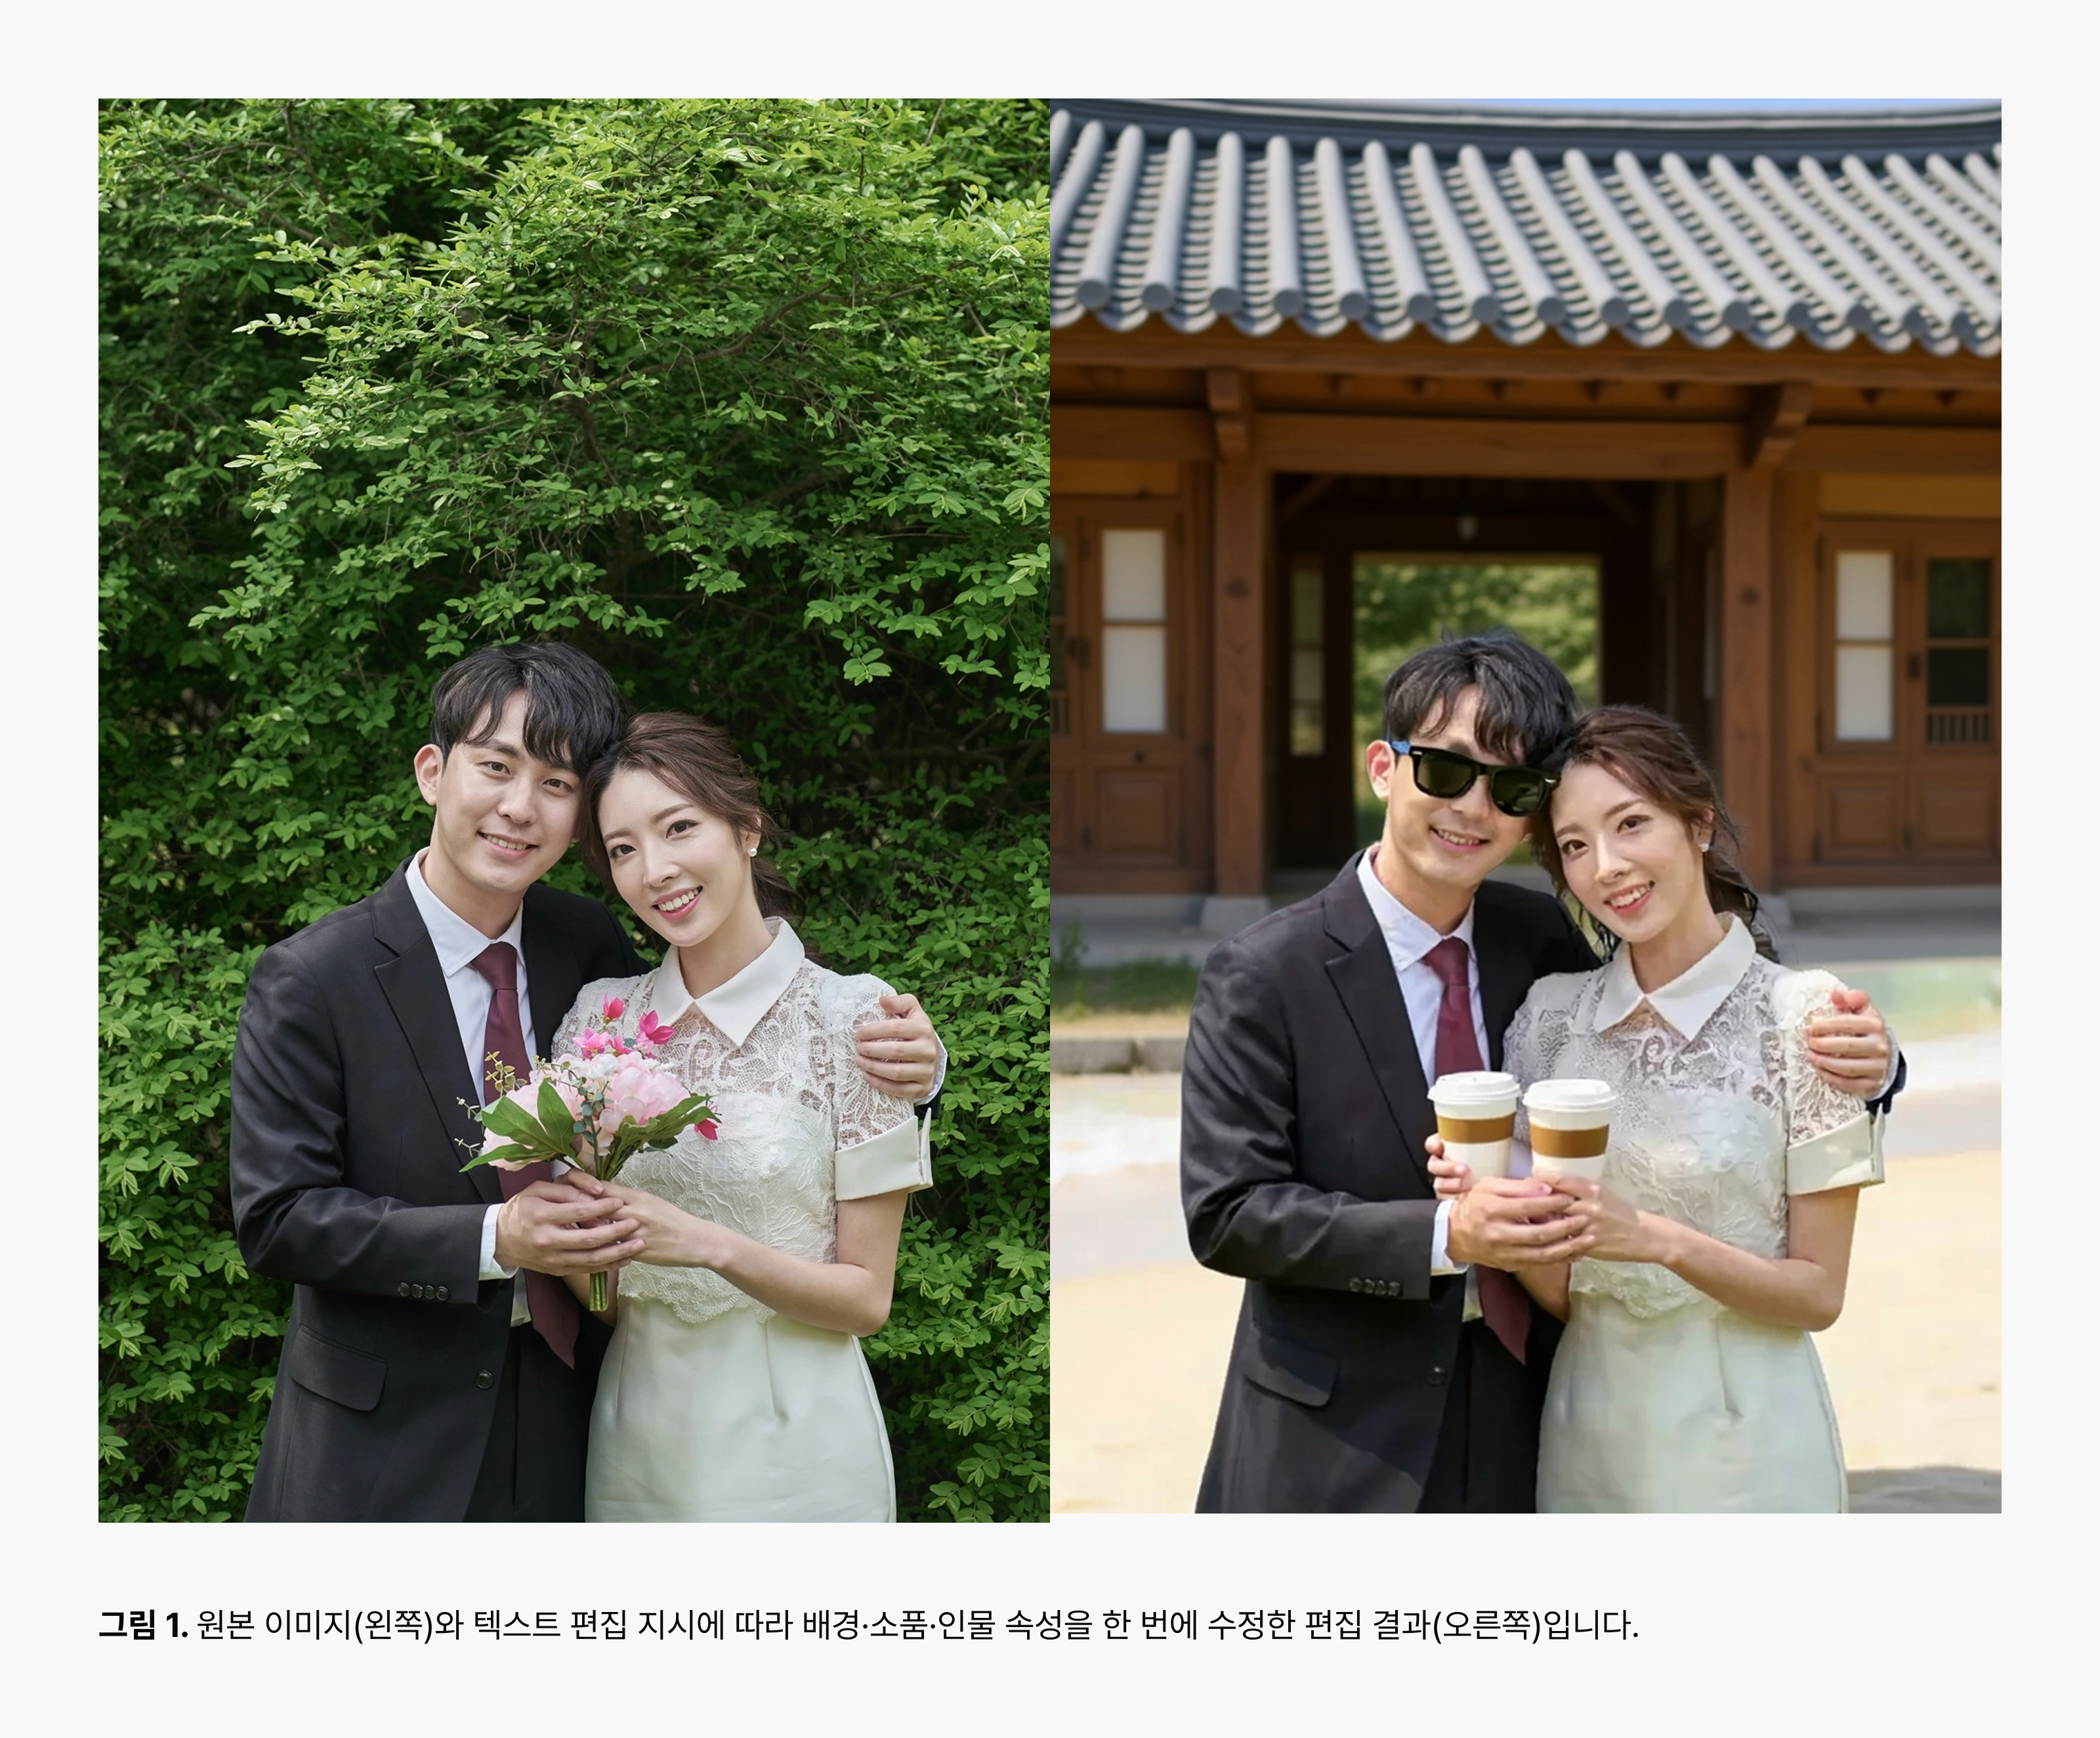
“한옥을 배경으로, 두 사람은 커피를 들고 남자는 선글라스를 쓰도록 바꿔줘.”
이 지시대로 이미지를 편집하려면 모델은 무엇부터 배워야 할까요?
이미지 생성 모델은 새로운 이미지를 만드는 데서 더 나아가, 복잡한 요구에 맞춰 기존 이미지를 수정하는 등 다양한 시각 콘텐츠 제작에 활용되고 있습니다. 활용 범위가 넓어질수록 모델은 더 다양한 장면을 이해하고 여러 형태의 지시를 처리할 수 있어야 합니다.
이를 위해 더 많은 데이터로 학습하고 필요에 따라 모델 규모도 키워야 합니다. 다만 규모가 커질수록 학습 시간과 연산 자원도 함께 늘어납니다. 따라서 제한된 시간과 연산 자원 안에서 충분한 데이터를 학습하고 목표 품질에 도달할 수 있는 모델 구조와 학습 방법이 중요합니다.
네이버클라우드는 이미지 생성과 편집에 사용할 대규모 모델을 사전 학습된 가중치 없이 처음부터 직접 학습하고 있습니다. 모델 구조와 데이터, 학습 목표를 함께 설계하고 학습 전 과정을 추적하면서, 서비스 요구에 맞춰 독립적으로 개선하기 위해서입니다. 이미 학습된 공개 모델을 가져와 조정하는 방식이 아니므로, 편집 능력을 학습하기에 앞서 탄탄한 생성 능력부터 갖춰야 했습니다.
결정해야 할 것은 많았습니다. 이미지를 어떤 잠재 공간(latent space)에 압축할지, 어떤 핵심 신경망(backbone)과 최적화 알고리즘(optimizer)을 사용할지, 텍스트 조건 정보는 텍스트 인코더의 어느 계층을 얼마나 가져올지에 따라 같은 데이터와 연산 자원을 쓰더라도 학습 속도와 결과가 달라질 수 있습니다.
논문에서 보고된 결과를 그대로 적용할 수도 없었습니다. 모델 규모와 구조, 데이터 분포, 그리고 어떤 기술과 조합되는지가 변하면 같은 기법도 다르게 작용할 수 있기 때문입니다.
그래서 저희는 본격적인 대규모 학습에 앞서 유망한 기법을 작은 모델에 하나씩 적용해 검증했습니다. 그리고 실제로 좋은 성능을 보인 기법들을 순차적으로 조합하면서, 함께 적용했을 때도 성능 개선이 이어지는지 확인했습니다. 어떤 기준으로 후보를 선별했는지, 무엇이 실제 차이를 만들었는지, 기대와 달랐던 실험에서 무엇을 배웠는지 차례로 살펴보겠습니다.
1. 큰 학습에 들어가기 전, 작은 모델로 답을 찾다
학습 레시피를 탐색할 때 중요했던 것은 한 번의 최고 점수가 아니라, 빠르게 다음 질문으로 넘어갈 수 있는 실험 주기였습니다. 모델 크기와 해상도를 줄여 각 후보의 경향을 며칠 안에 확인하고, 가장 단순하면서 안정적인 설정을 기준 모델(baseline)로 삼았습니다. 이후에는 한 번에 한 가지 요소만 바꿔 결과의 원인을 분명히 했습니다.
기준 모델은 변분 오토인코더(Variational Autoencoder, VAE)로 압축한 잠재 공간에서 동작하는 잠재 확산 모델(Latent Diffusion Model, LDM)이었습니다. 이미지를 생성하는 핵심 신경망에는 텍스트와 이미지 토큰을 함께 처리하는 멀티모달 확산 트랜스포머(Multimodal Diffusion Transformer, MMDiT)를 사용했습니다.
검증은 두 단계로 진행했습니다. 먼저 ImageNet의 1,000개 범주 가운데 하나를 조건으로 주는 클래스 조건부(class-conditioned) 생성 실험에서 핵심 신경망, VAE, 학습 목표, 최적화 알고리즘을 개별적으로 비교했습니다. 사용자 지시문을 이해하는 과정의 영향을 덜어내고 확산 모델 자체의 학습 특성을 보기 위해서입니다. 이 단계에서 효과가 확인된 기술은 문장과 이미지가 짝지어진 텍스트 기반 이미지 생성(T2I) 데이터에서 추가 검증을 진행했습니다. 특히 여러 기법을 함께 적용했을 때의 조합 가능성은 실제 목표에 더 가까운 T2I 환경에서 중점적으로 확인했습니다.
정량 평가에는 서로 다른 측면을 살펴보는 네 가지 지표를 사용했습니다.
- FID [1]: 생성 이미지와 실제 이미지의 분포가 얼마나 가까운지 보여주는 지표입니다. 낮을수록 좋습니다.
- DINO-MMD [2, 3]: 생성 이미지와 실제 이미지의 분포를 DINO 시각 인코더의 표현 공간에서 비교하는 지표입니다. 낮을수록 좋습니다.
- CLIP 점수 [4]: 생성 이미지가 설명문(caption)의 내용을 얼마나 잘 반영하는지 보여주는 지표입니다. 높을수록 좋습니다.
- Aesthetic 점수 [5]: 사람이 선호할 만한 미적 품질을 추정하는 지표입니다. 높을수록 좋습니다.
정량 지표가 놓치는 차이는 같은 프롬프트 묶음으로 각 모델이 생성한 이미지를 사람이 직접 비교해 확인했습니다. 특히 글자, 손가락, 반복 무늬처럼 정량 지표로 측정하기 어려운 T2I 모델의 취약점을 살펴보기 위해 해당 요소가 포함된 프롬프트를 함께 사용했습니다.
모델 구조를 비교할 때는 학습 스텝 수뿐 아니라 실제 경과 시간(wall-clock)도 함께 봤습니다. 대규모 학습에서 실제로 제한되는 자원은 스텝 수가 아니라 GPU 시간이기 때문입니다. 한 스텝에서 더 잘 배우는 구조라도 스텝당 처리 시간이 길면, 같은 시간 동안 더 적은 데이터를 학습하게 되어 결과적으로 비효율적일 수 있습니다.
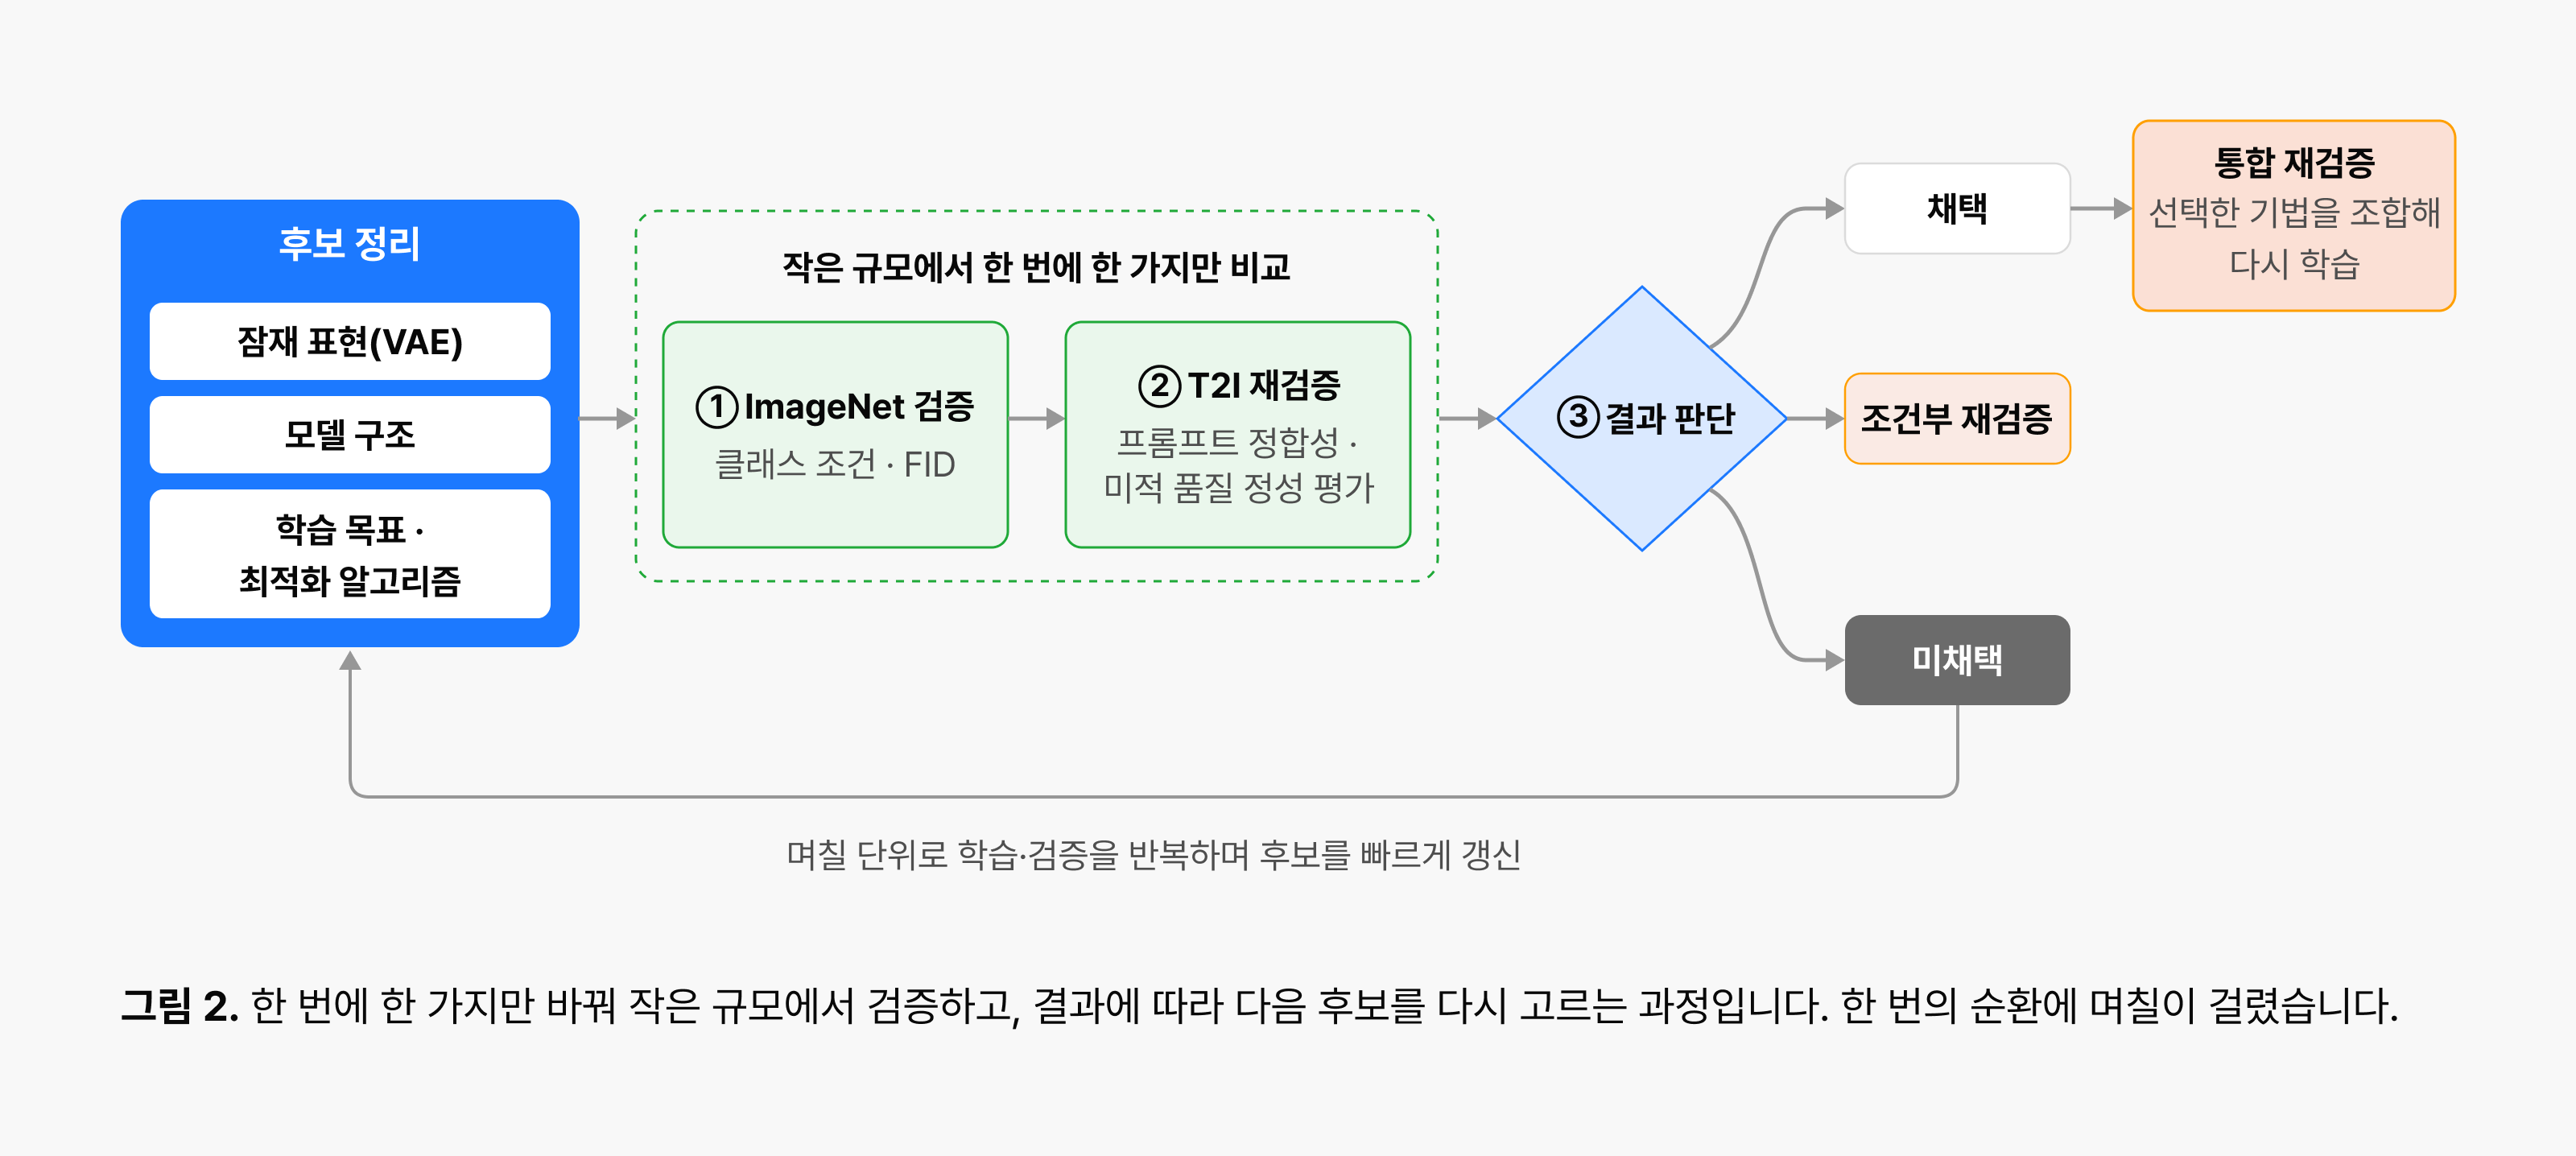
작은 실험의 결과를 단순히 채택과 탈락으로만 나누지는 않았습니다. 작은 규모에서도 차이가 분명한 기법은 우선 채택했습니다. 반면 모델의 수용력(model capacity)이 커지거나 입력 시퀀스가 길어질 때 장점이 나타날 가능성이 있는 기법은 더 큰 규모에서 다시 확인할 후보로 남겼습니다.
2. 실제로 큰 차이를 만든 기법은 무엇일까?
먼저 이미지의 잠재 표현(latent representation), 가중치 갱신 방식, 학습할 노이즈 구간을 점검했습니다. 이어 표현 학습, 블록 사이의 정보 전달, 텍스트 조건까지 범위를 넓혀 최종 레시피에 포함할 기법을 검증했습니다.
같은 핵심 신경망, 다른 잠재 공간이 만든 학습 속도 차이
이미지 생성 모델은 일반적으로 원본 이미지의 모든 픽셀을 그대로 학습하지 않습니다. 먼저 변분 오토인코더(Variational Autoencoder, VAE)를 이용해 이미지를 생성 모델이 다루기 쉬운 잠재 공간(latent space)으로 압축한 뒤, 이 공간에서 이미지의 생성 과정을 학습합니다. 생성 모델이 만든 잠재 표현(latent representation)을 다시 실제 이미지로 복원하는 것도 VAE의 역할입니다.
쉽게 말해 VAE는 원본 이미지를 생성 모델이 이해할 수 있는 형태로 바꾸는 번역기와 같습니다. 같은 이미지를 사용하더라도 VAE가 달라지면 생성 모델이 전달받는 표현의 형태와 분포가 달라집니다. 따라서 어떤 VAE를 선택하느냐에 따라 모델이 이미지를 배우는 난이도와 속도도 달라질 수 있습니다.
이는 LLM에서 토크나이저가 입력을 어떻게 나누느냐에 따라 학습 난이도가 달라지는 것과 비슷합니다. 이미지 모델에서는 VAE가 만드는 잠재 공간의 성질이 학습의 출발점을 결정합니다.
저희는 이러한 차이를 확인하기 위해 FLUX.1 VAE와 FLUX.2 VAE [6]를 같은 핵심 신경망(backbone)에 연결해 비교했습니다. 두 구성의 처리량 차이는 0.4%에 불과해, 스텝 당 학습 시간에는 사실상 큰 차이가 없는 조건이었습니다.
그런데 학습 결과에서는 뚜렷한 차이가 나타났습니다. 225k 스텝에서 FID는 FLUX.1 VAE 구성의 10.95에서 FLUX.2 VAE 구성의 10.19로 약 7% 낮아졌습니다.
최종 FID보다 더 눈에 띈 것은 목표 품질에 도달하는 속도였습니다. FID 30에 도달한 시점이 87.5k 스텝에서 50k 스텝으로 앞당겨졌습니다. FLUX.2 VAE를 사용한 모델은 같은 품질 기준에 37.5k 스텝 먼저 도달한 것입니다. 두 구성의 처리량이 거의 같았기 때문에, 줄어든 스텝 수는 실제 학습 시간의 절감으로 이어졌습니다.
이는 대규모 모델 학습에서 중요한 차이입니다. 최종 성능이 조금 좋아지는 것도 의미가 있지만, 같은 품질에 더 적은 스텝과 더 짧은 시간으로 도달하면 제한된 GPU 자원으로 더 많은 실험을 하거나 다음 학습 단계로 더 빨리 넘어갈 수 있기 때문입니다.
이 결과는 FLUX.2 VAE가 제시한 학습 효율 개선을 유사한 구성의 이미지 범주 조건 생성 실험에서 재확인한 것입니다. 저희의 최종 목표는 텍스트 기반 이미지 편집이므로, 실제 문장을 입력하는 T2I 환경에서도 VAE 교체에 따른 같은 경향이 나타나는지 이어서 확인했습니다.
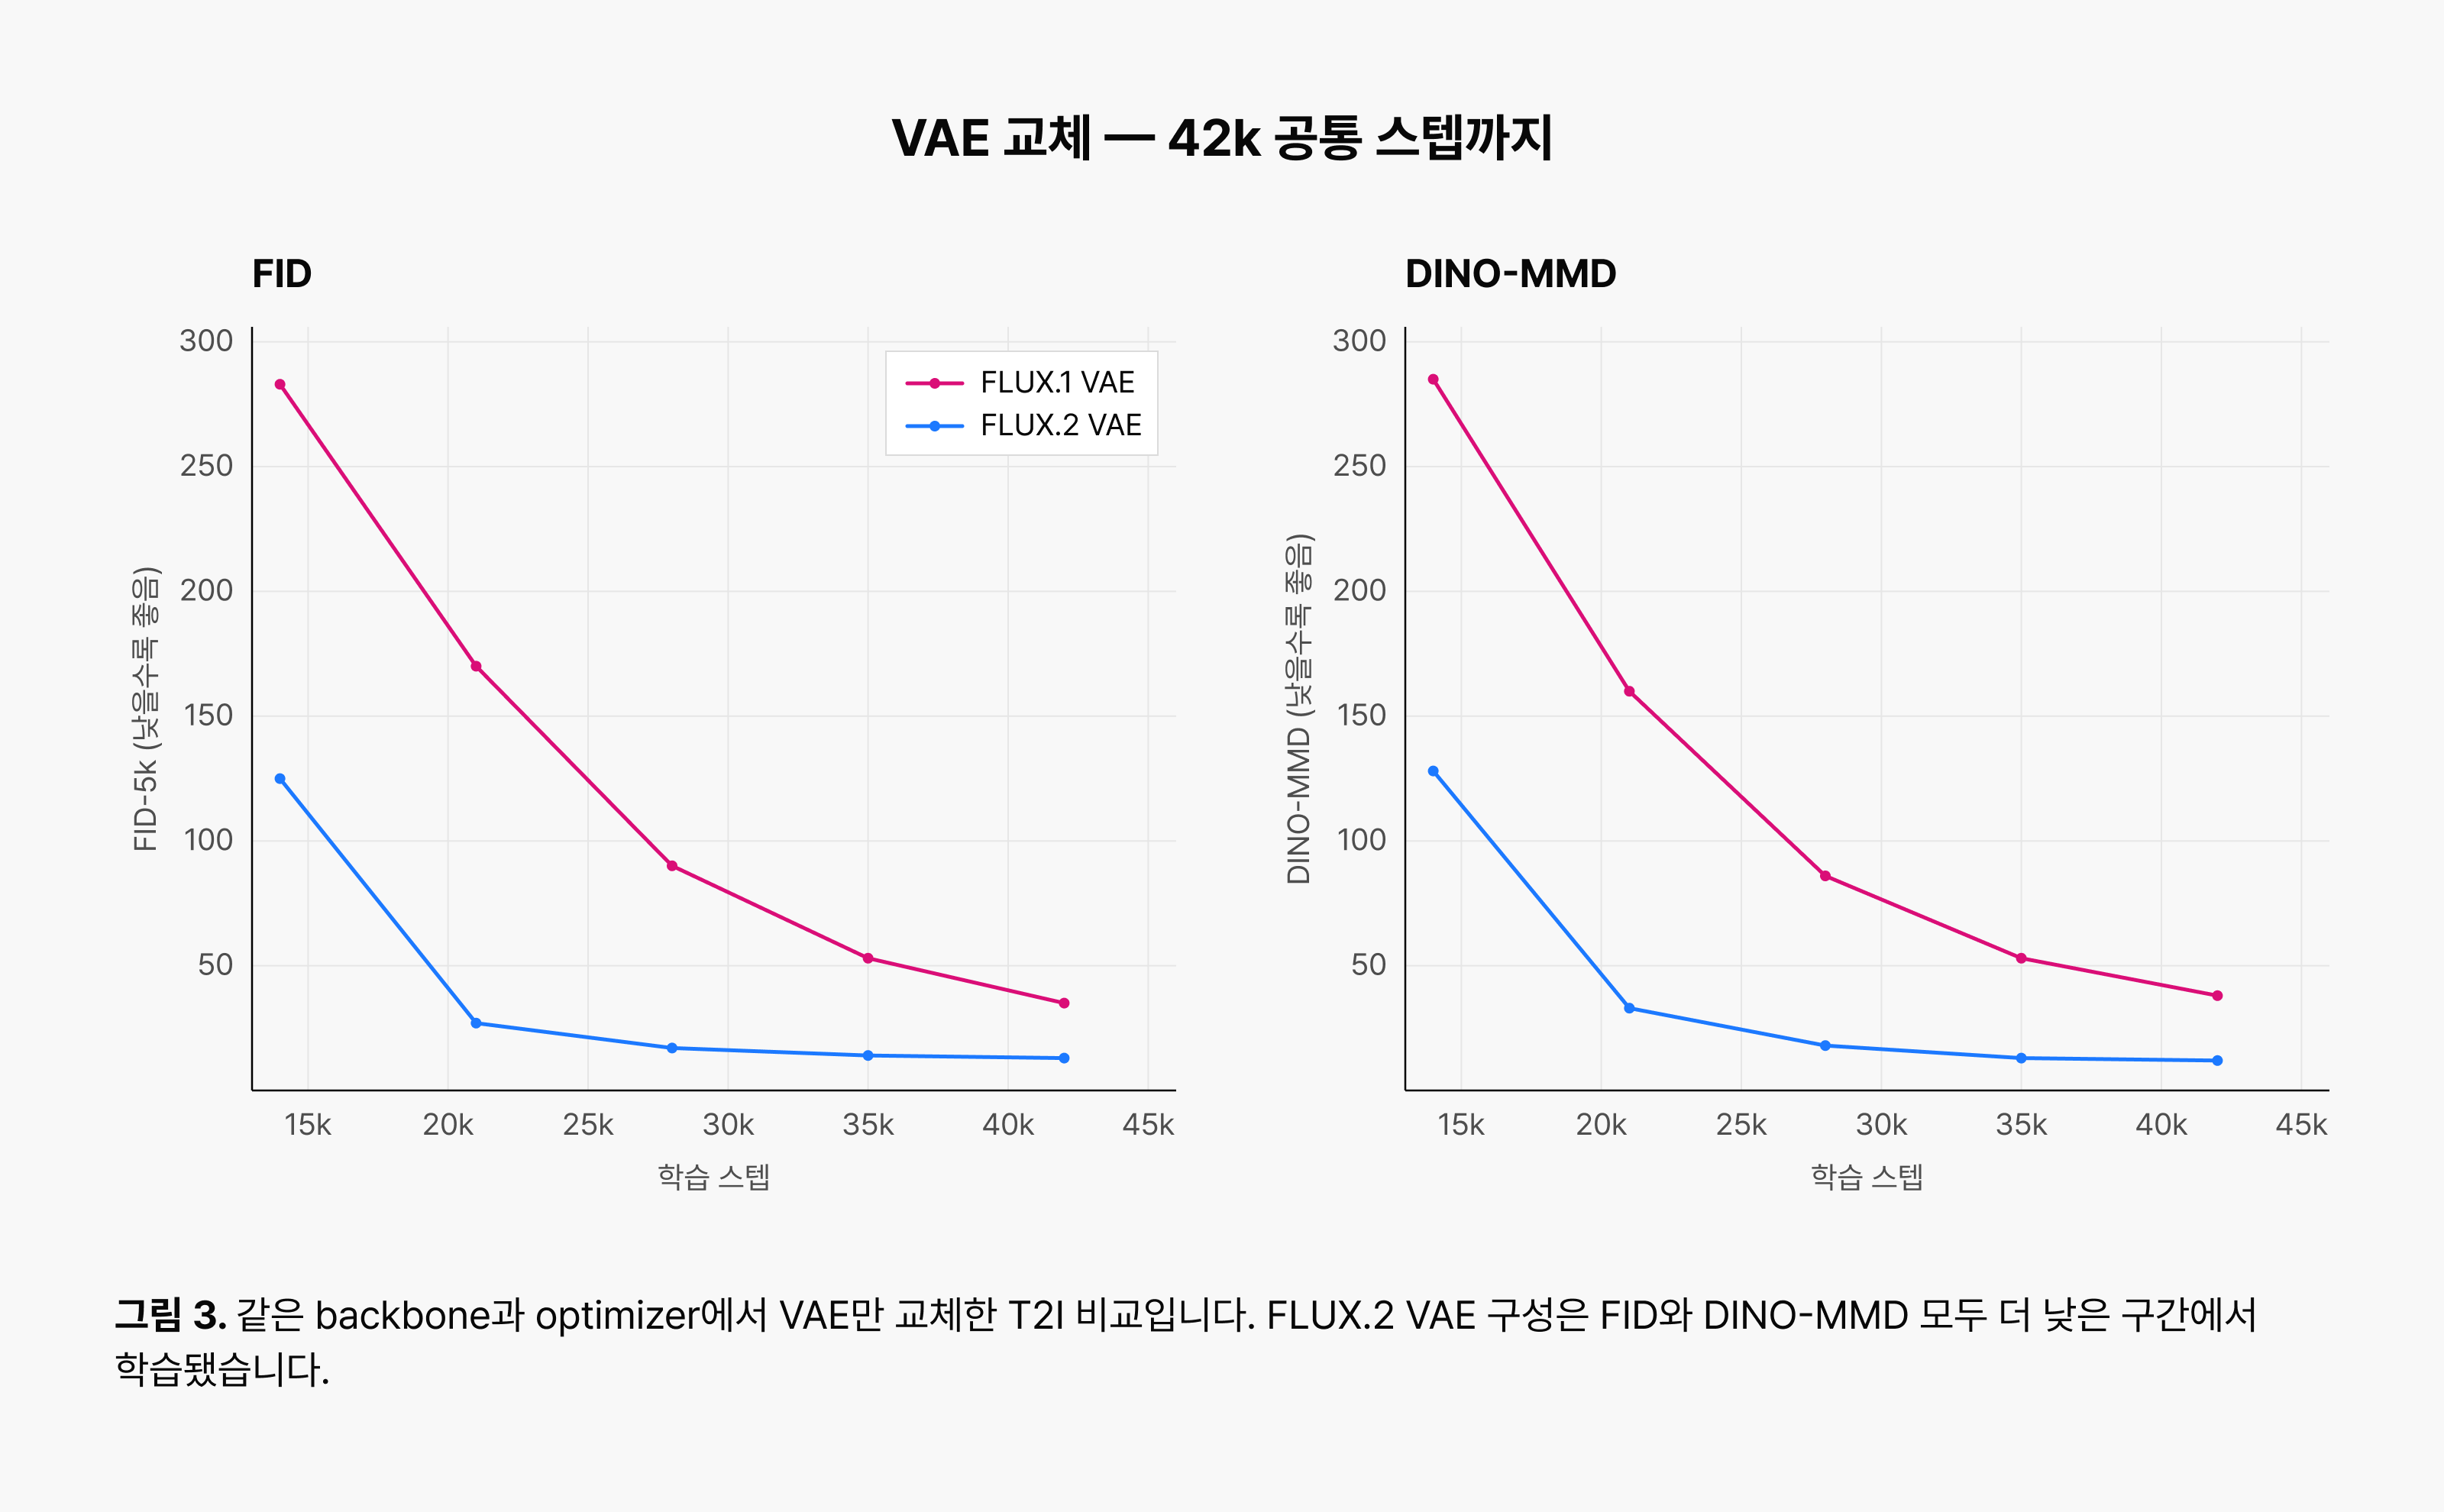
두 구성을 공통으로 비교할 수 있는 42k 스텝에서 FLUX.1 VAE를 사용한 기준 구성의 FID와 DINO-MMD는 각각 35.12와 37.77이었습니다. FLUX.2 VAE로 교체한 구성에서는 각각 13.19와 11.05로 낮아졌습니다.
ImageNet과 T2I 실험 모두에서 학습 초반부터 차이가 나타났다는 점을 바탕으로, FLUX.2 VAE가 현재 모델의 학습 공간에 더 적합하다고 판단했습니다.
VAE 교체에 따른 차이는 학습 초반부터 크게 나타났습니다. 이를 더 분명하게 보여주기 위해 아래 그래프에는 두 구성을 함께 비교할 수 있는 14k 스텝부터 42k 스텝까지의 학습 추이를 표시했습니다.
같은 시간 동안 더 많이 배우게 하려면?
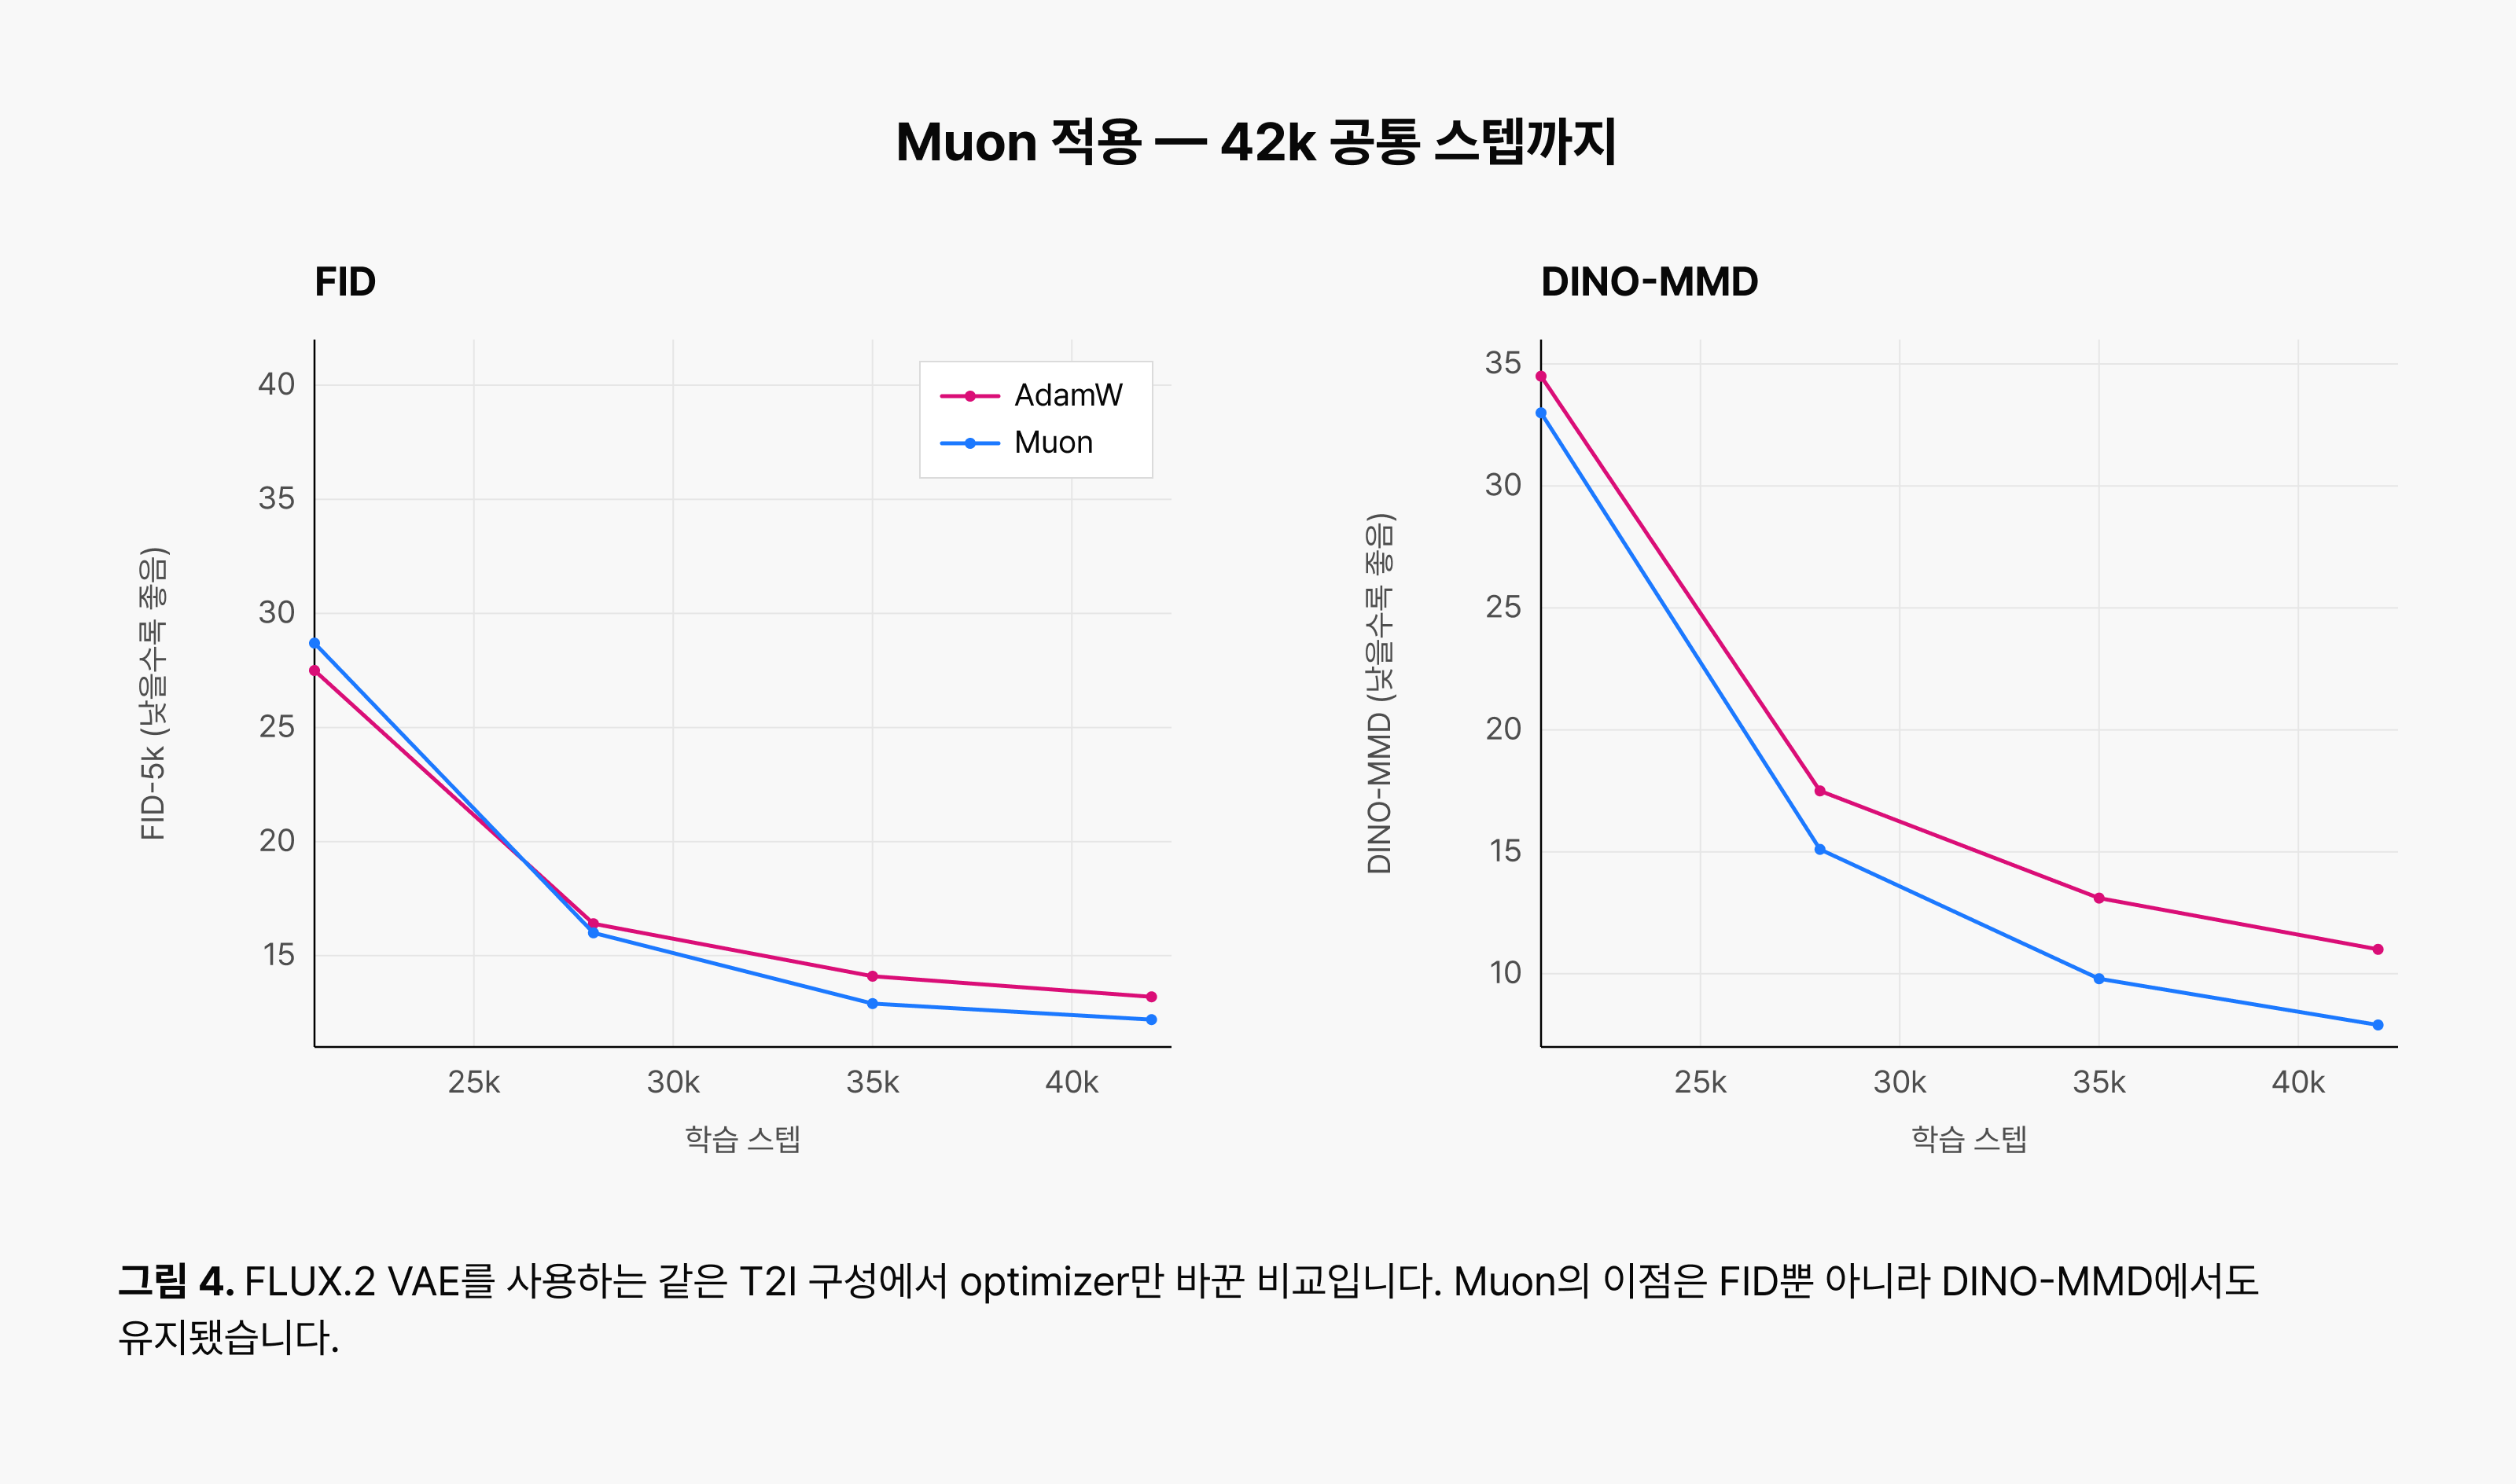
VAE를 바꿔 모델이 학습할 공간을 정한 다음에는, 그 공간에서 모델의 가중치를 어떻게 업데이트할지 살펴봤습니다. 최적화 알고리즘(optimizer)은 학습 과정에서 계산한 기울기(gradient)를 실제 가중치 변화에 반영하는 규칙입니다. 모델 구조와 손실 함수가 같더라도 어떤 최적화 알고리즘을 사용하느냐에 따라 목표 성능에 도달하는 속도가 달라질 수 있습니다.
저희는 기존에 널리 사용하는 AdamW [7]와 Muon [8]을 비교했습니다. Muon은 행렬 형태의 가중치 갱신이 특정 방향에 지나치게 몰리지 않도록 조정합니다. 모델 구조와 손실 함수는 그대로 두고 가중치 갱신 방식만 바꾸기 때문에, AdamW와 직접 비교하기 쉽고 다른 학습 기법과도 조합하기 좋습니다.
먼저 ImageNet 실험에서 동일한 FID에 도달하는 데 필요한 학습 스텝 수를 비교했습니다. AdamW는 150k 스텝에서 FID 12에 도달한 반면, Muon은 37.5k 스텝에서 같은 수준에 도달했습니다.
다만 Muon은 가중치를 갱신하는 과정에 추가 연산이 필요해 스텝당 처리 시간이 AdamW보다 길었습니다. 따라서 스텝 수가 줄었다는 사실만으로 실제 학습 시간까지 단축됐다고 판단할 수는 없습니다. 이를 확인하기 위해 실제 경과 시간을 기준으로 두 구성을 다시 비교했습니다. 학습 시작 후 36시간 시점의 FID는 AdamW 10.19, Muon 5.20이었습니다. 즉, 스텝당 처리 시간의 차이를 고려해도 Muon이 같은 시간 안에 더 낮은 FID에 도달했습니다.
저희는 분산 환경에서 병렬 구현을 적용해 Muon의 추가 연산 부담을 상당 부분 줄였습니다. 스텝 수뿐 아니라 동일한 실제 경과 시간에서도 품질 향상을 확인했기 때문에 Muon을 최종 학습 레시피에 포함했습니다.
자연어 프롬프트로 이미지를 생성하는 T2I 실험에서도 같은 경향이 나타났습니다. 두 구성을 공통으로 비교할 수 있는 42k 스텝에서 FLUX.2 VAE를 적용한 구성의 FID와 DINO-MMD는 각각 13.19와 11.05였습니다. 여기에 최적화 알고리즘만 Muon으로 바꾸자 각각 12.07과 7.96으로 낮아졌습니다. 단순한 이미지 범주 조건뿐 아니라 실제 문장을 입력하는 환경에서도 Muon의 이점이 유지된 것입니다.
학습에 좋은 노이즈 설정이 생성에도 정답일까?
이미지 생성 모델은 아무 형태도 없는 노이즈에서 시작해 이를 여러 단계에 걸쳐 줄이면서 이미지를 만듭니다. 플로 매칭(flow matching) [9]은 완전한 노이즈와 깨끗한 이미지 사이의 여러 지점을 학습합니다. 모델은 노이즈가 많이 섞인 상태부터 이미지에 가까운 상태까지 다양한 입력을 보며, 각 지점에서 어느 방향으로 이동해야 하는지 배웁니다.
이때 노이즈 이동 값(noise shift)은 모델이 어떤 노이즈 구간을 더 자주 학습할지 결정합니다. 이번 설정에서는 이동 값이 클수록 노이즈가 많은 구간에, 작을수록 노이즈가 적은 구간에 상대적으로 더 큰 비중을 둡니다. 결국 이 값을 어떻게 설정하느냐에 따라 모델이 학습 과정에서 자주 접하는 문제의 난도가 달라집니다.
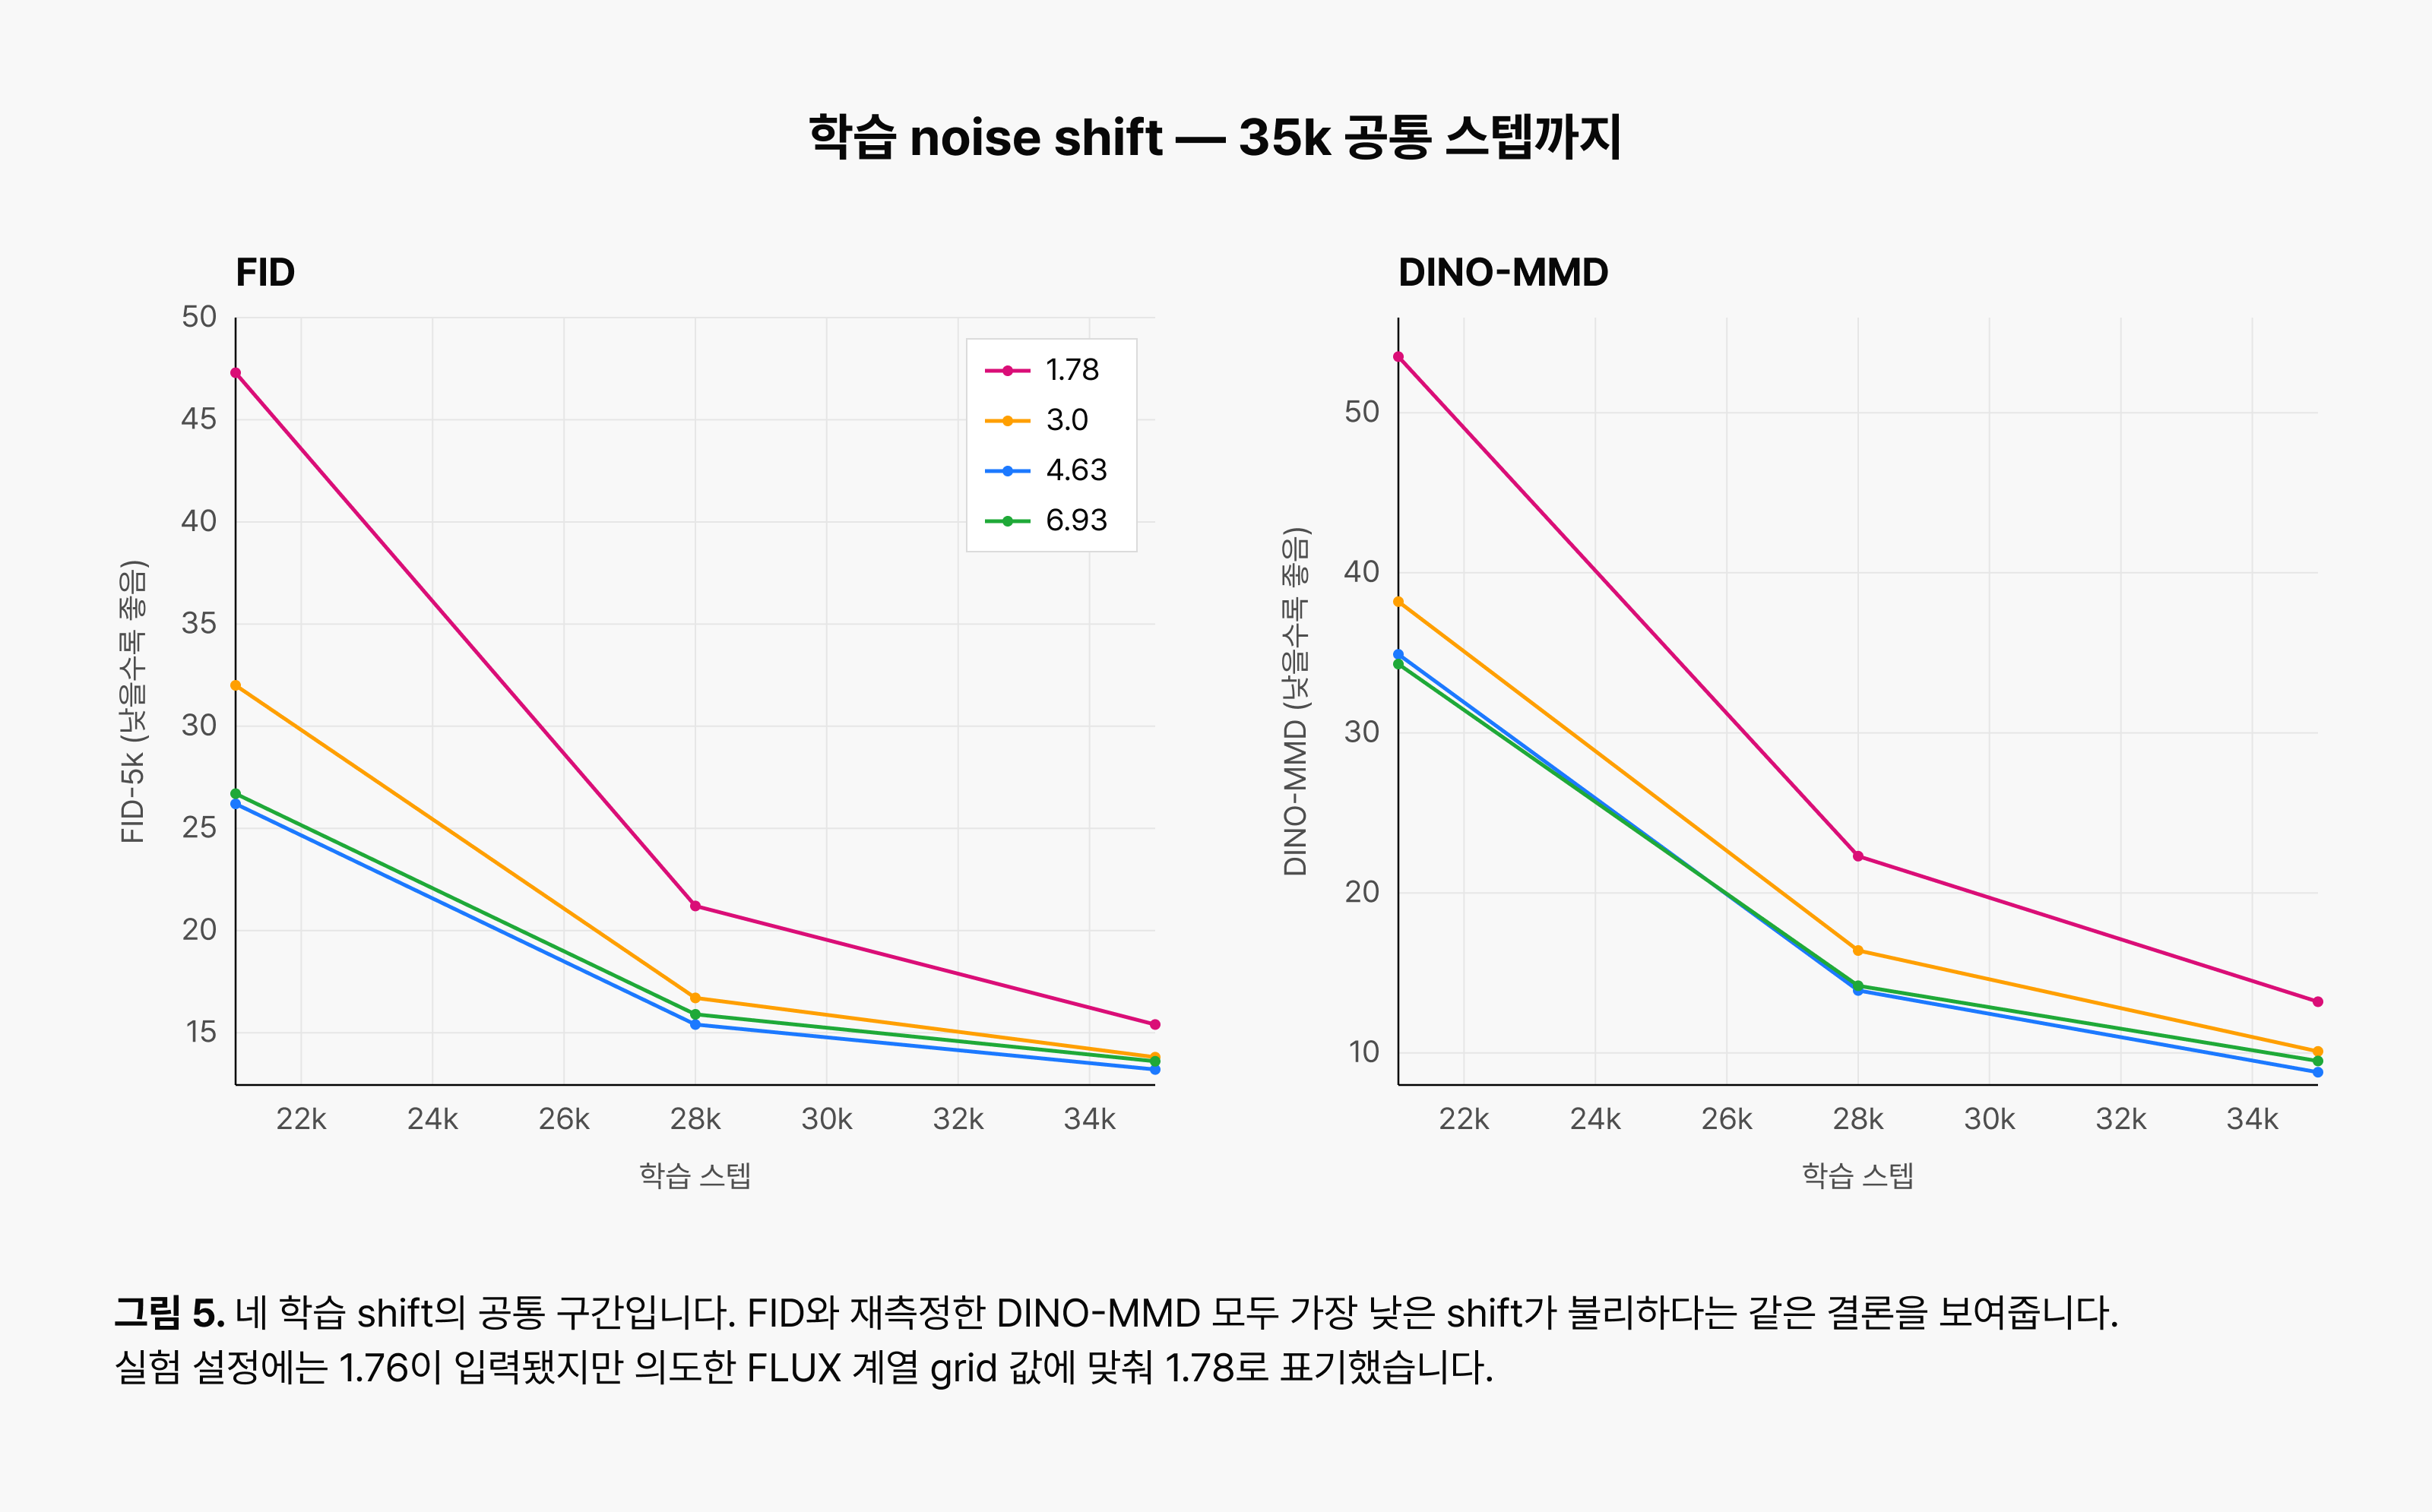
저희는 먼저 네 가지 학습 이동 값을 비교했습니다. 그 결과 가장 낮은 값만 뚜렷하게 불리했고, 중간 범위의 값들은 서로 비슷한 성능을 보였습니다. 학습 시 노이즈 수준을 정하는 시간 변수의 샘플링 분포도 logit-normal, plateau, uniform으로 바꿔봤지만 차이는 크지 않았습니다.
반면 학습이 끝난 모델에서 이미지를 생성할 때 사용하는 이동 값만 바꾸자 다른 양상이 나타났습니다. 실험한 1.78~6.93 범위에서는 생성 이동 값을 높일수록 FID가 낮아졌습니다.
이 결과는 학습할 때 좋은 설정이 이미지 생성 과정에서도 그대로 좋은 설정이 되는 것은 아니라는 점을 보여줍니다. 학습 이동 값은 모델이 어떤 노이즈 구간을 중심으로 배울지 정하고, 생성 이동 값은 학습된 모델이 이미지를 만들어가는 과정을 조정합니다. 역할이 다른 만큼 두 값을 하나로 고정하지 않고 각각 따로 맞추는 편이 적합했습니다.
이미지를 이해하는 능력이 생성 품질을 높일 수 있을까
생성 손실만으로도 모델은 노이즈가 섞인 잠재 표현을 깨끗한 이미지 쪽으로 이동시키는 방법을 배울 수 있습니다. 하지만 이것만으로 이미지 안에 무엇이 있고 각 요소가 어떻게 배치돼 있는지를 나타내는 내부 표현(internal representation)까지 충분히 학습된다고 보장하기는 어렵습니다. 의미 정보를 잘 담은 내부 표현이 이미지 생성에 도움이 된다는 점은 이전 연구에서도 알려져 있습니다 [10, 11].
이러한 내부 표현을 학습하는 대표적인 방법이 표현 정렬(representation alignment)입니다. REPA [12]는 확산 트랜스포머의 중간 특징(feature)을, 의미 정보를 잘 담도록 미리 학습된 외부 시각 인코더의 표현과 맞춥니다.
저희가 적용한 Self-Flow [13]는 외부 인코더를 사용하지 않습니다. 대신 학습 중인 모델의 지수 이동 평균(exponential moving average, EMA) 사본을 교사(teacher)로 활용합니다.
교사 모델에는 같은 이미지에서 노이즈가 덜 섞인 입력을 보여주고, 학생(student) 모델에는 일부 토큰이 더 많이 손상된 입력을 보여줍니다. 학생 모델은 교사가 만든 표현을 목표로 삼아, 더 많은 노이즈가 섞인 상태에서도 노이즈가 더 적은 입력의 의미와 구조를 찾아내도록 학습합니다. 이미지 생성 방법과 함께 이미지를 이해하는 내부 표현도 익히게 하는 과정입니다.
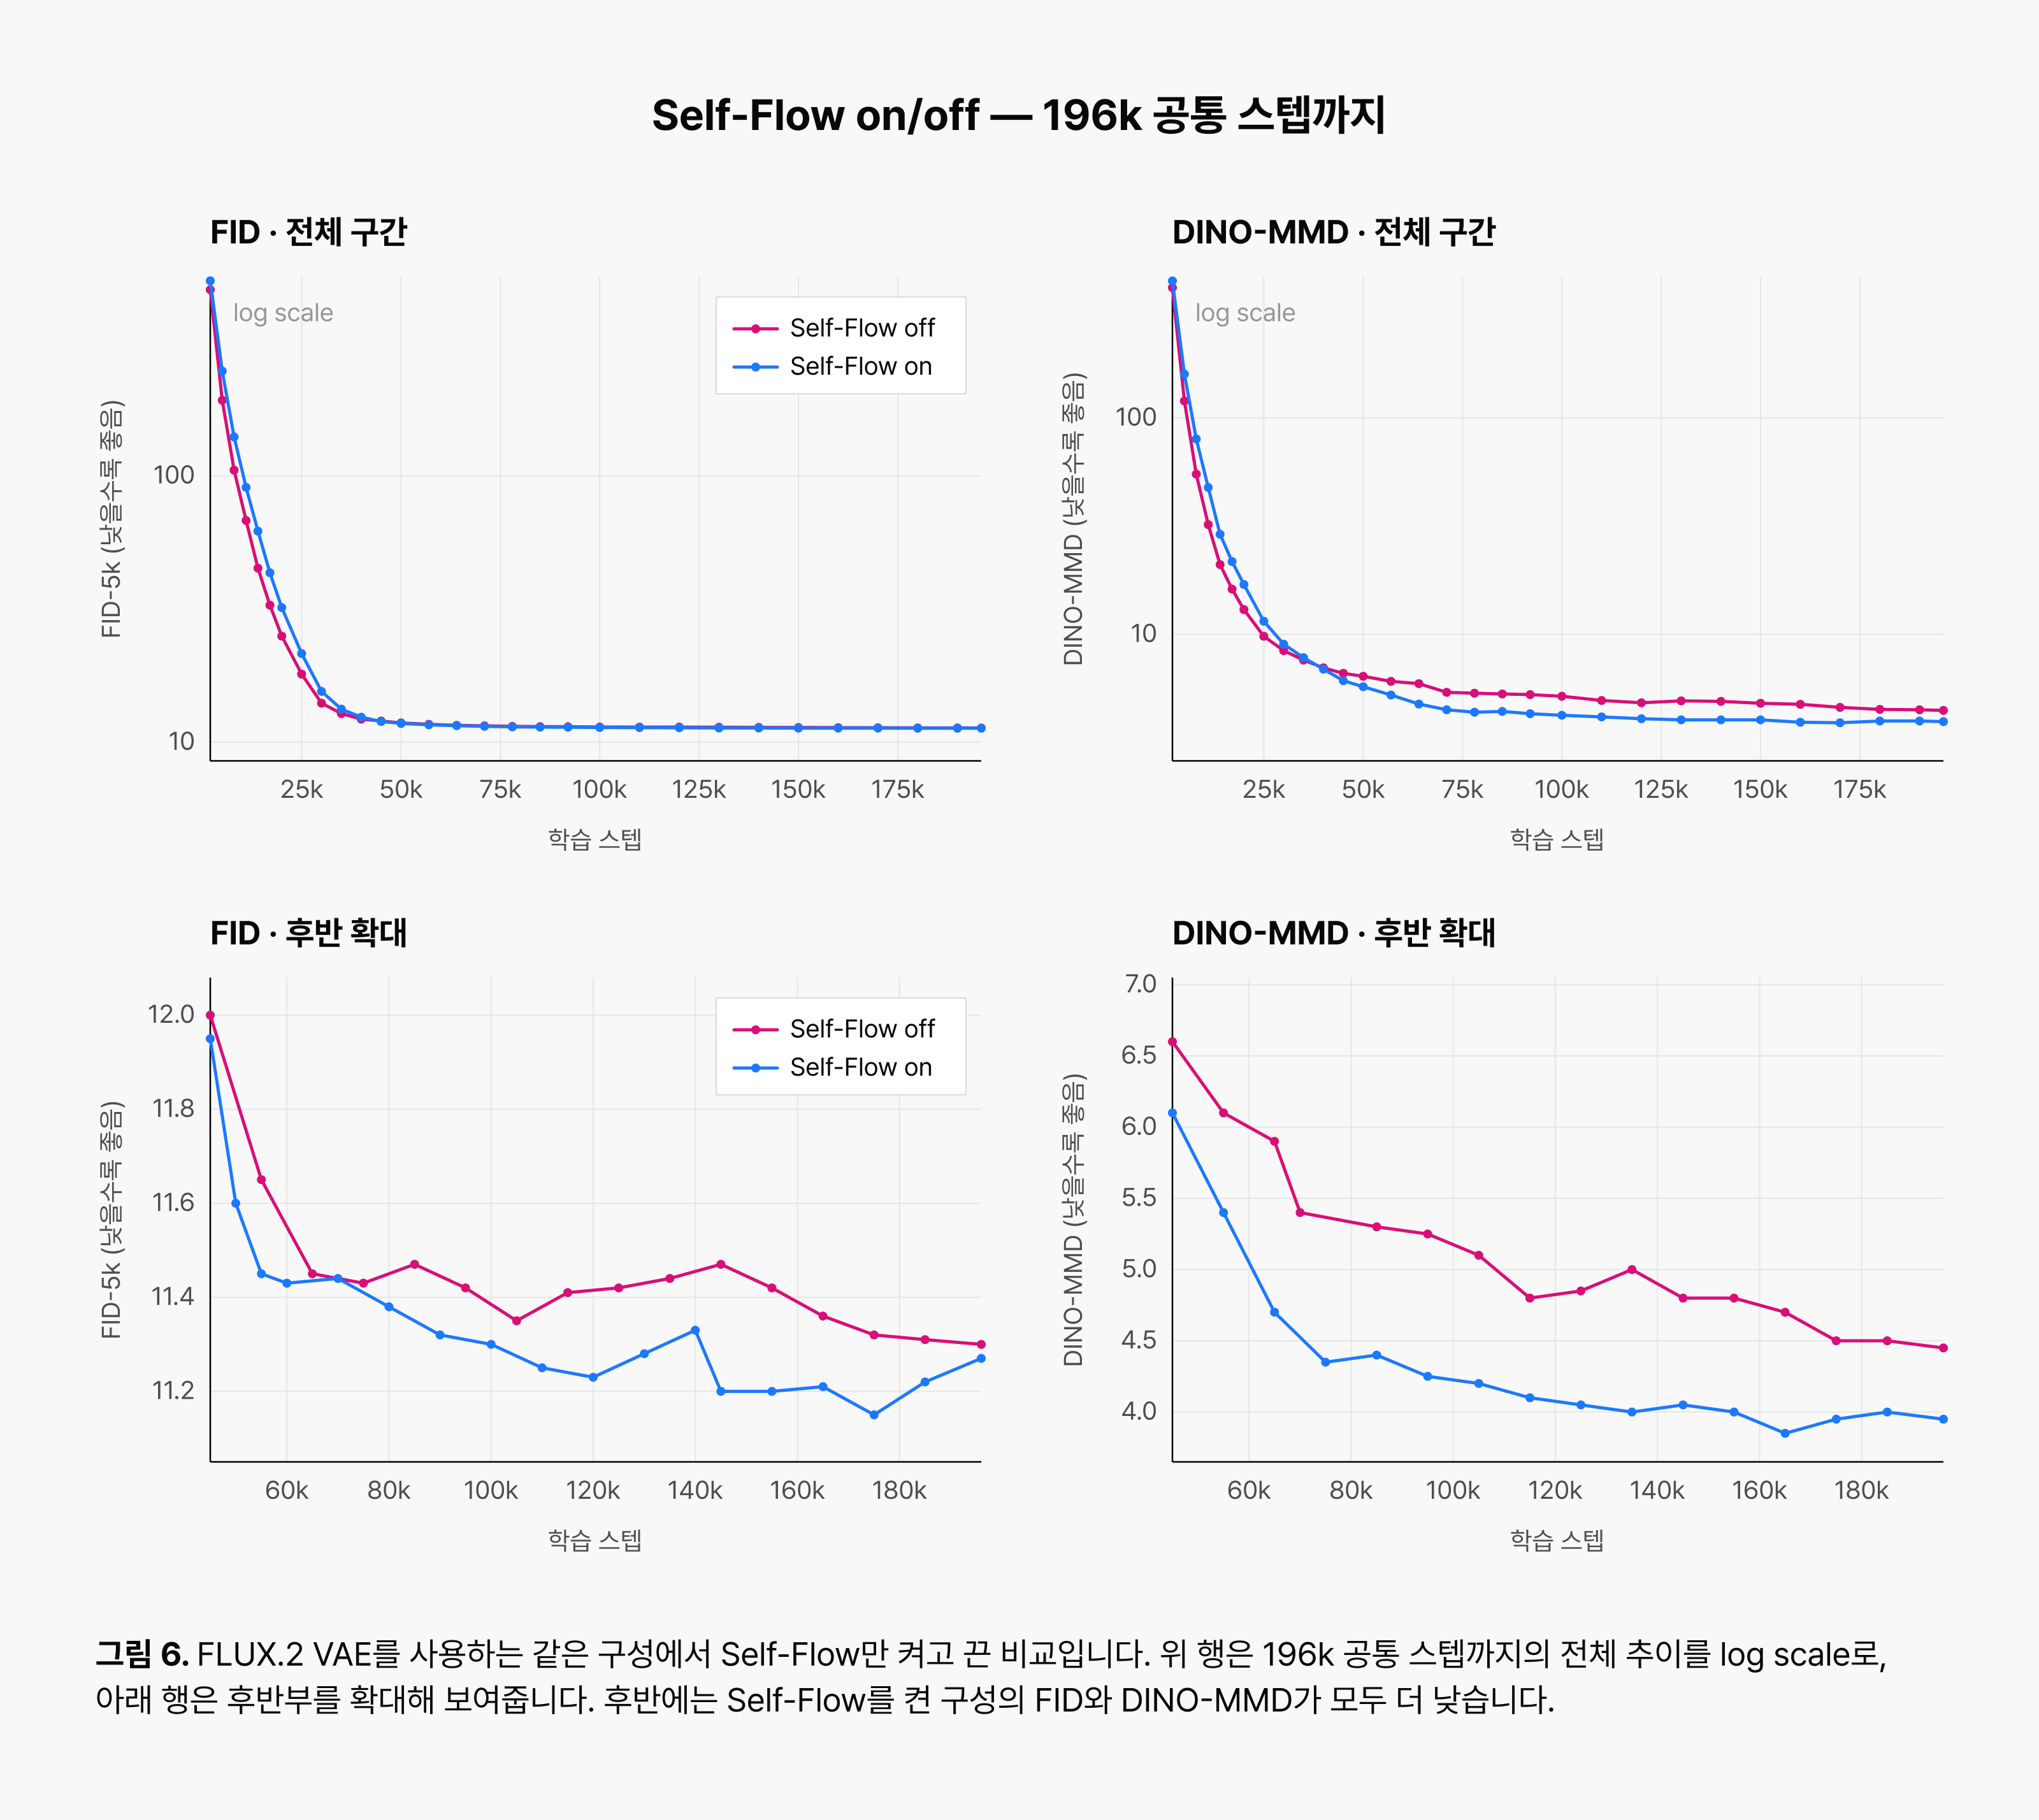
먼저 FLUX.2 VAE와 Muon을 적용한 42k 스텝까지 학습한 T2I 구성에 Self-Flow를 추가했습니다. FID는 12.07에서 12.41로 비슷하게 유지됐지만, DINO-MMD는 7.96에서 7.01로 낮아졌습니다. 짧은 학습 구간에서는 FID만으로 이점을 판단하기 어려웠지만, DINO 표현 공간에서 이미지 분포를 비교하는 DINO-MMD에서는 개선이 먼저 나타났습니다.
Self-Flow의 효과가 학습 후반에 더 뚜렷해지는지 확인하기 위해 두 구성을 196k 스텝까지 학습했습니다. 147k 스텝에서 Self-Flow를 끈 구성과 켠 구성의 FID는 각각 11.47과 11.25였고, DINO-MMD는 4.85와 4.05였습니다. 196k 스텝에서의 FID는 11.30과 11.27로 차이가 작았지만, DINO-MMD는 4.46에서 3.91로 낮아졌습니다. 후반 학습 구간에서는 Self-Flow를 적용한 구성의 FID도 대체로 더 낮게 나타났습니다.
충분히 학습한 뒤 이점이 더 분명해지는 이러한 수렴 양상은 Self-Flow 논문 [13]의 일부 실험에서 보고된 경향과 같은 방향입니다. 비교 기법의 개선이 정체된 뒤에도 Self-Flow는 계속 개선됐고, 이점을 확인하기까지 더 긴 학습이 필요했습니다.
저희도 짧은 구간의 FID 한 점만으로 결론을 내리지 않았습니다. 후반부 학습 곡선과 DINO-MMD를 함께 살펴본 결과, 학습이 길어질수록 Self-Flow의 이점이 나타난다고 판단해 최종 레시피에 포함했습니다.
앞에서 찾은 정보를 끝까지 잃지 않으려면?
이미지 생성 모델은 여러 블록을 거치며 입력 정보를 단계적으로 처리합니다. 이 과정에서 앞쪽 블록이 포착한 위치와 경계 같은 정보가 뒤쪽 블록까지 전달되는 동안 약해질 수 있습니다. 롱 스킵(long skip)은 앞쪽에서 얻은 정보를 여러 블록을 거치지 않고 뒤쪽으로 직접 전달하는 연결 방식입니다.
이 방식은 U-Net [14]을 통해 널리 알려졌습니다. U-Net은 인코더 앞부분의 특징 맵(feature map)을 대응하는 디코더 계층으로 직접 전달합니다. 중간의 병목 구간을 통과하면서 희미해질 수 있는 위치와 경계 정보를 이미지 복원 과정에서 다시 활용하기 위해서입니다.
이후 U-ViT [15]는 롱 스킵을 확산 트랜스포머에 적용해 얕은 계층과 깊은 계층을 대칭으로 연결했습니다. U-Net과 같은 축소·확대 경로가 없지만, 앞쪽에서 얻은 정보를 뒤쪽까지 직접 전달하는 연결 자체가 생성 성능에 도움이 될 수 있음을 보여줬습니다.
최근에는 i1 [16]이 현대적인 T2I 핵심 신경망에서 이 설계를 다시 검토해 여러 모델 크기와 구조에서 일관된 이점을 확인했습니다. 저희도 앞쪽 트랜스포머 블록에서 형성된 공간 정보와 텍스트 조건을 뒤쪽 블록이 직접 다시 사용할 수 있도록 롱 스킵을 적용했습니다. 앞쪽과 뒤쪽의 대칭되는 블록 사이에서 이미지 토큰과 텍스트 토큰을 함께 전달하는 방식입니다.
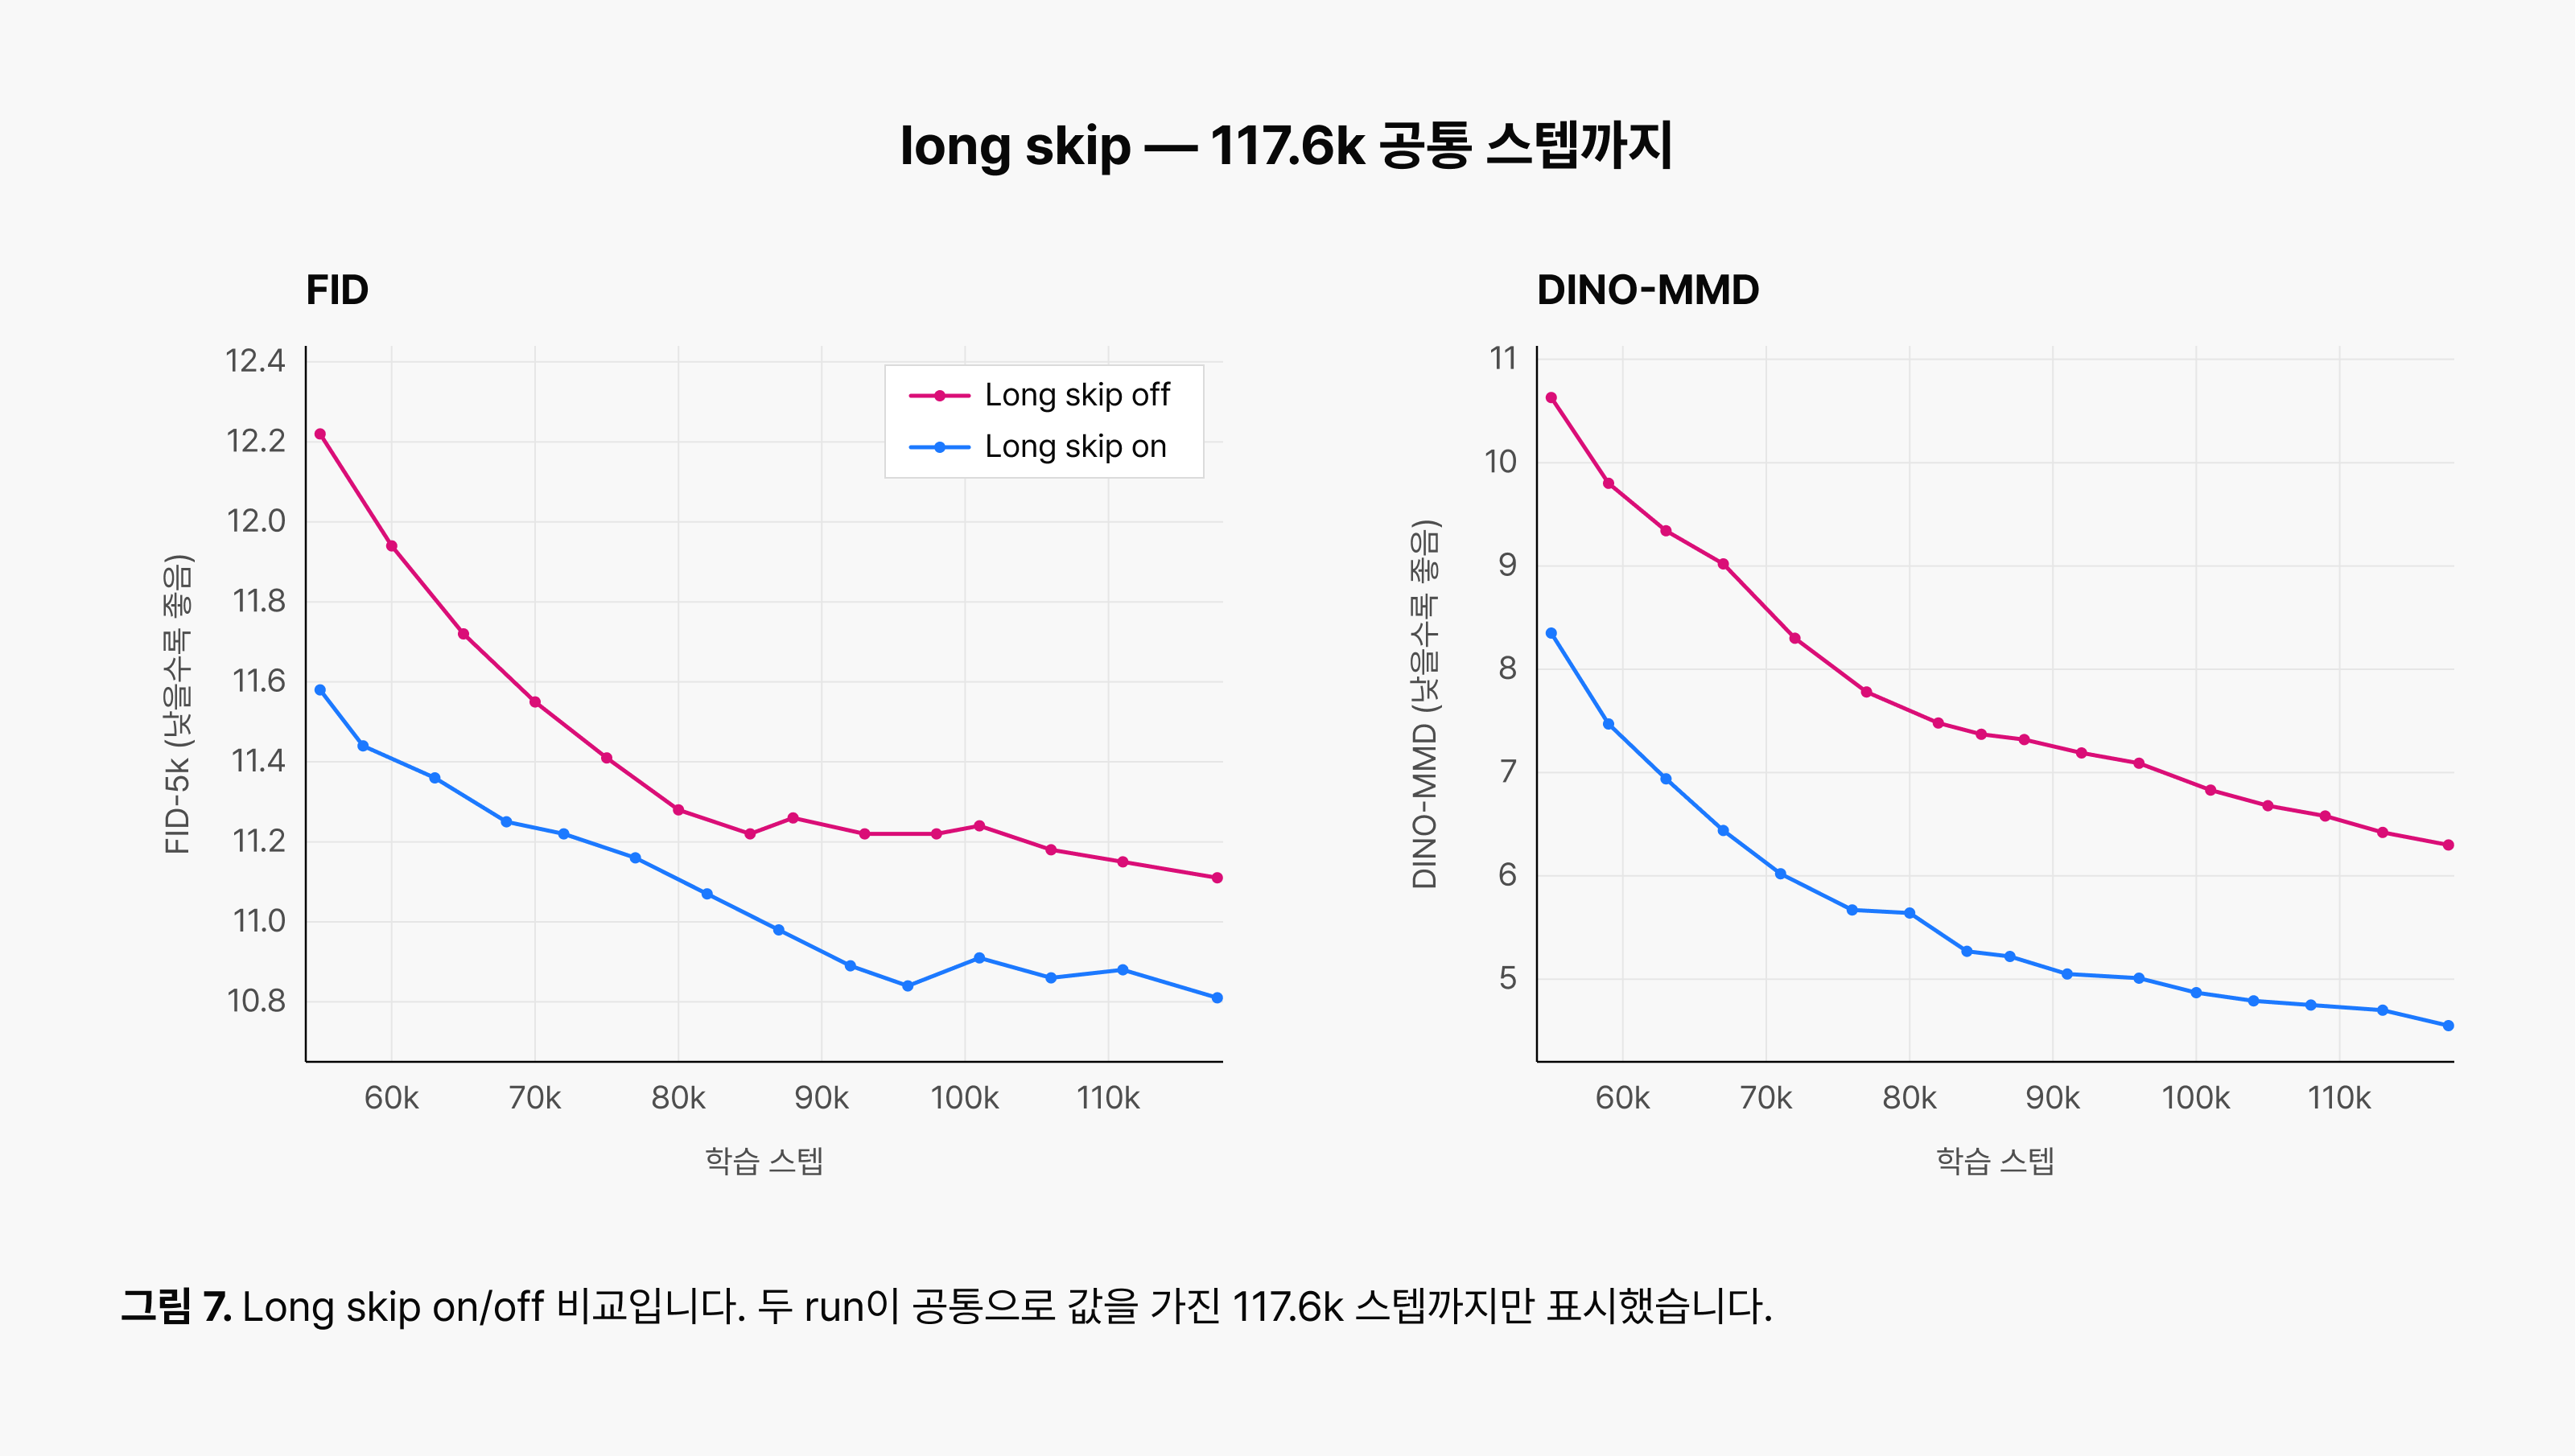
롱 스킵 자체의 효과를 확인하기 위해 다른 조건은 유지하고, 이 연결을 켠 구성과 끈 구성을 비교했습니다. 두 구성을 함께 비교할 수 있는 117.6k 스텝에서 롱 스킵을 끈 구성과 켠 구성의 FID는 각각 11.11과 10.81이었습니다. 같은 구성의 재측정 DINO-MMD는 6.30과 4.53이었습니다.
FID만 보면 차이가 크지 않아 보이지만, 다른 시각 표현 공간에서 이미지 분포를 비교하는 DINO-MMD에서는 개선 폭이 더 분명했습니다. 앞쪽 블록의 정보를 뒤쪽까지 직접 전달하는 구조가 현재 모델에서도 유효하다는 점을 두 지표로 확인했습니다.
글자를 그려보니, 텍스트를 이해하는 방식이 보였습니다
T2I 모델이 사용자의 지시대로 이미지를 만들려면 프롬프트의 의미를 정확히 이해해야 합니다. 이를 위해 텍스트 인코더가 문장을 분석하고, 그 결과인 은닉 상태(hidden state)를 이미지 생성 모델에 조건으로 전달합니다.
그런데 텍스트 인코더의 모든 계층이 같은 정보를 담는 것은 아닙니다. 계층의 깊이에 따라 표현에 담기는 정보의 추상도와 세부 정도가 달라질 수 있습니다. 저희는 프롬프트 전체의 의미를 이해하는 데 필요한 정보와 이미지 안에 글자의 세부 형태를 표현하는 데 필요한 정보가 서로 다른 깊이에 담겨 있을 가능성에 주목했습니다.
이 모델은 VLM을 텍스트 인코더로 사용합니다. 저희는 VLM의 마지막 계층 하나만 사용하는 방식과 여러 중간 계층의 표현을 이어 붙여(concatenate) 함께 사용하는 방식을 비교했습니다.
그 결과 서로 다른 깊이의 표현을 함께 사용한 구성이 일반적인 T2I 평가에서도 안정적인 성능을 보였습니다. 특히 이미지 안에 글자를 생성하는 텍스트 렌더링에서 차이가 가장 선명했습니다.
한 계층의 표현만 사용한 모델은 단어의 철자를 틀리거나 같은 글자를 두 번 겹쳐 쓰는 경우가 있었습니다. 반면 여러 깊이의 표현을 함께 사용한 모델은 동일한 학습 스텝 수에서 글자를 더 정확하게 생성했습니다. 학습 손실이나 전체 평균 지표에서는 거의 보이지 않던 차이가 실제 이미지에서는 바로 드러난 것입니다.
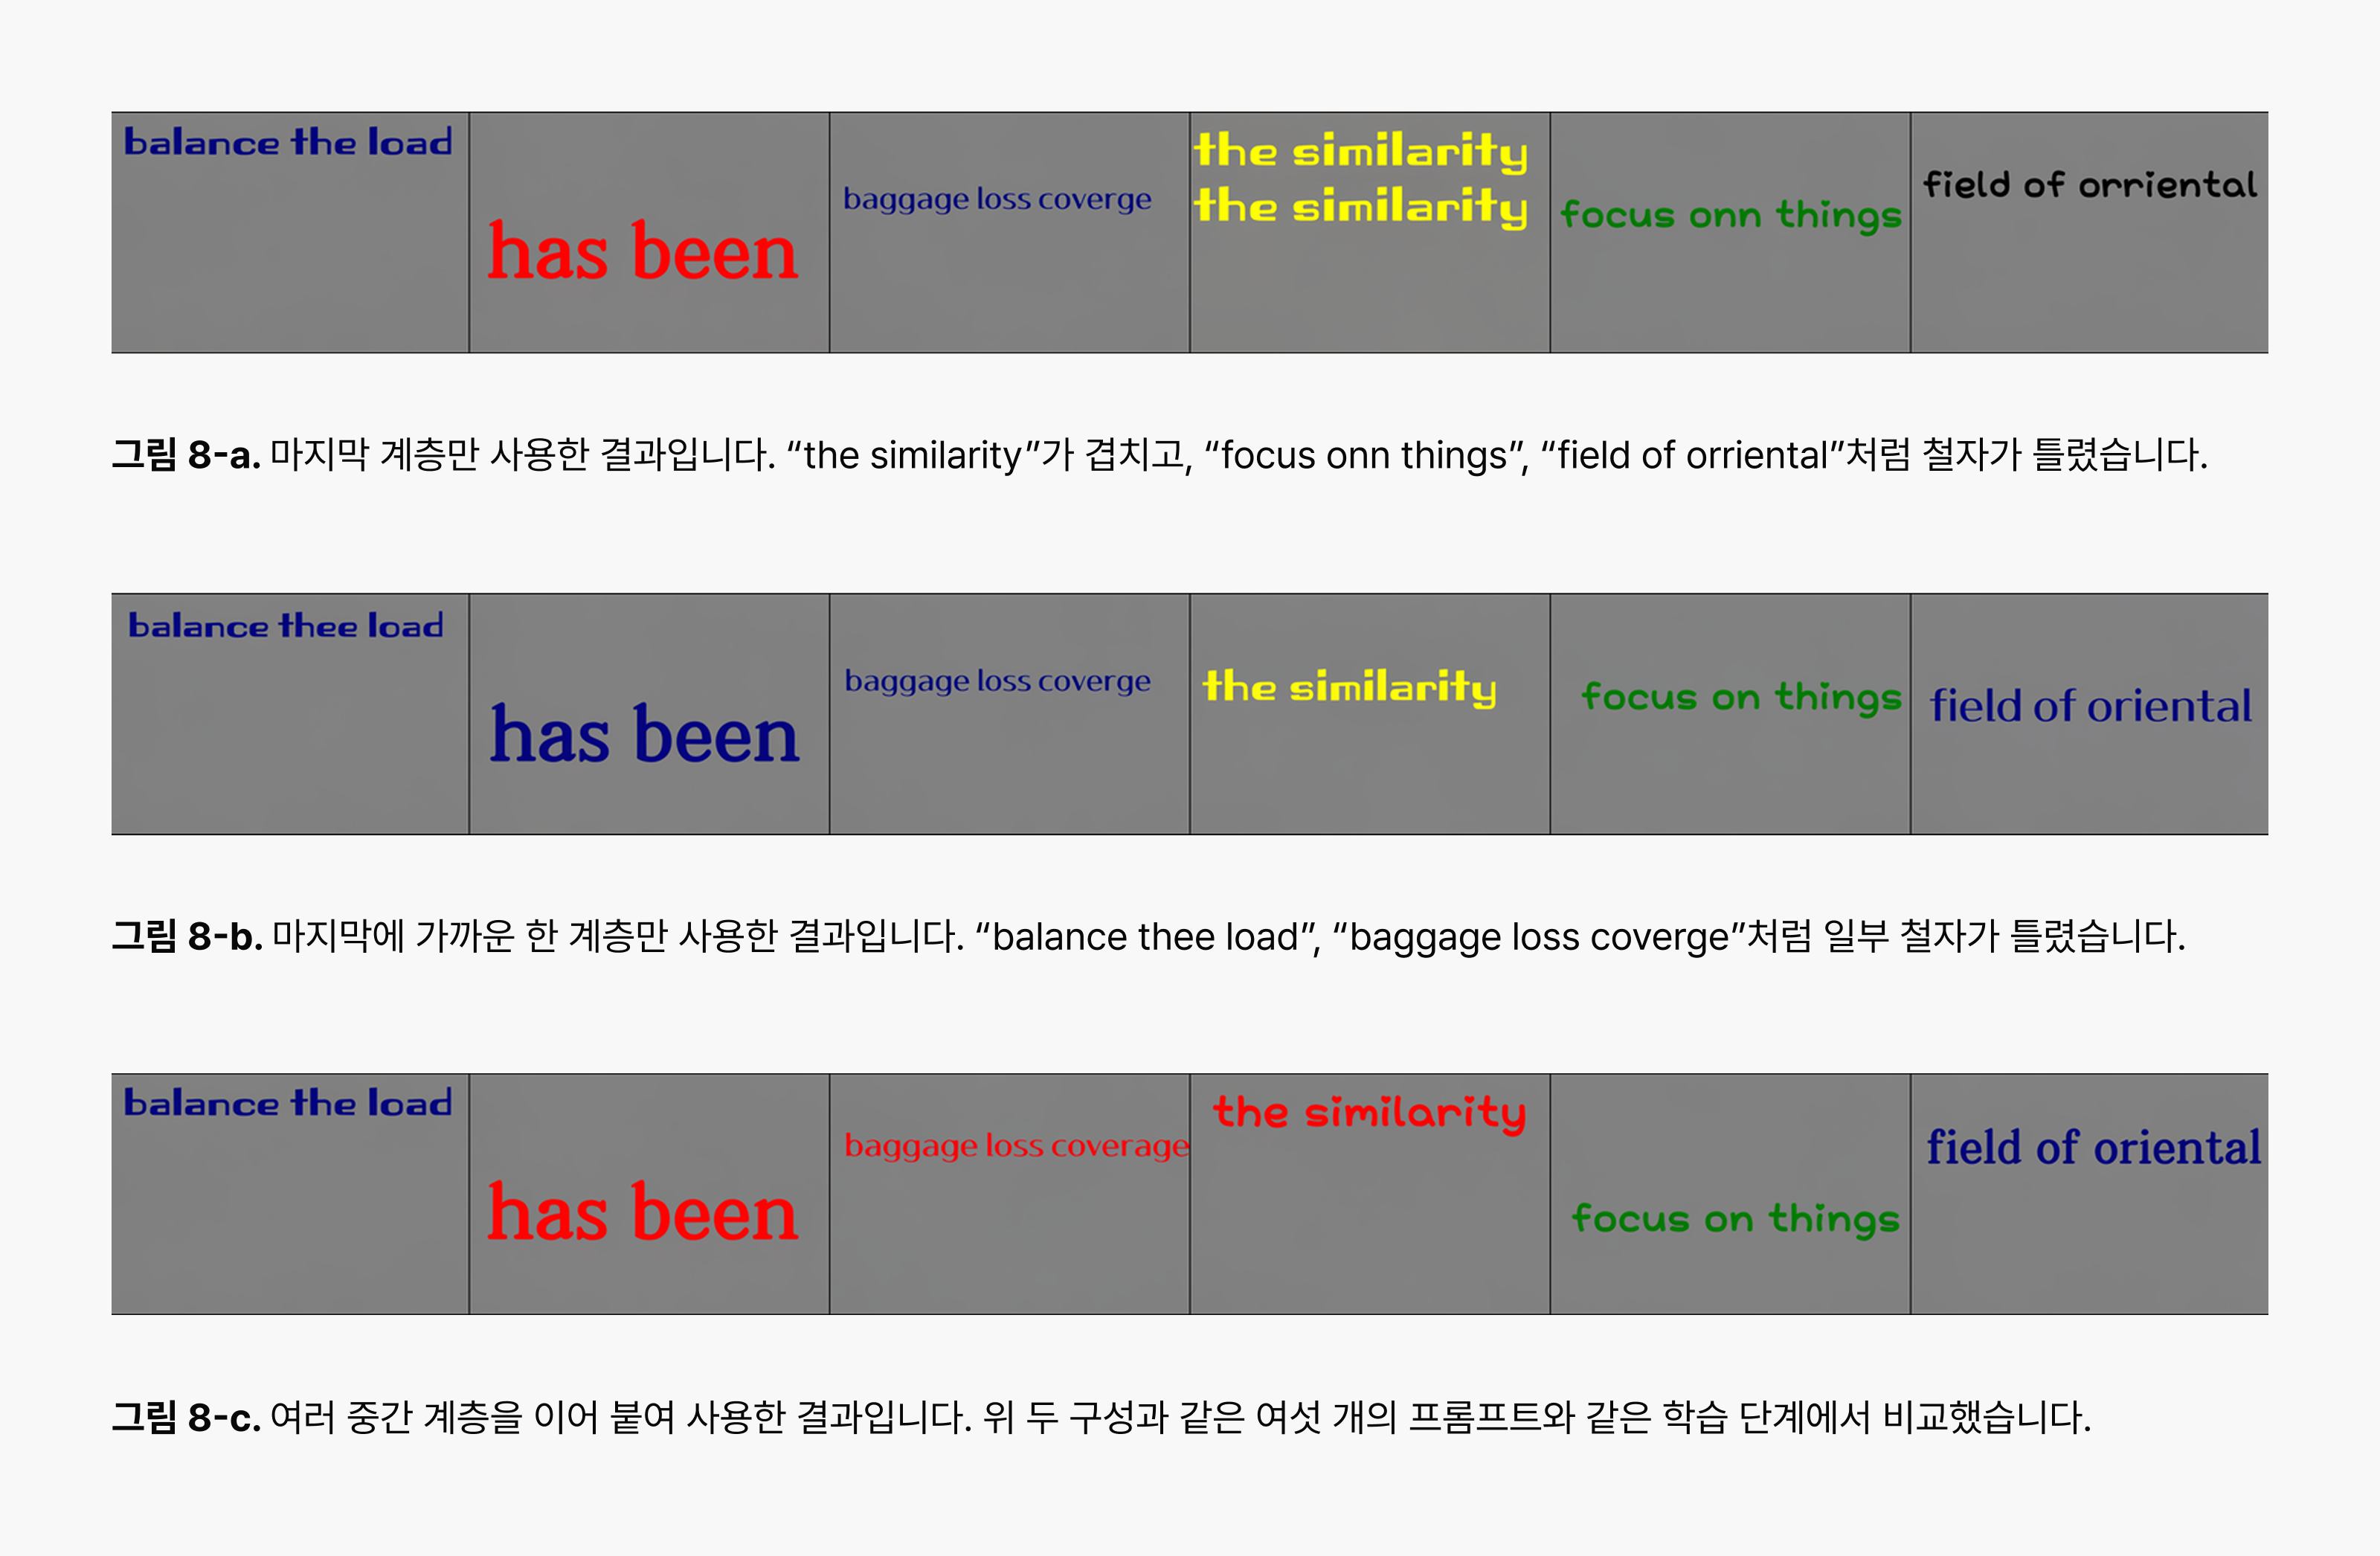
이 실험을 통해 텍스트 렌더링이 텍스트 조건 구조의 차이를 확인하는 민감한 평가 기준이 될 수 있다는 점을 확인했습니다. 일반적인 생성 이미지에서는 구도나 질감이 달라 어느 결과가 더 나은지 판단하기 어려울 수 있습니다. 하지만 글자는 한 글자만 틀려도 차이가 명확하게 드러납니다.
따라서 텍스트를 정확히 이해하고 이미지 안에 표현해야 하는 모델에서는 전체 평균 점수뿐 아니라 텍스트 렌더링 결과도 함께 살펴봐야 합니다. 저희는 이 결과를 바탕으로 VLM의 여러 중간 계층을 함께 사용하는 텍스트 조건 구조를 최종 레시피에 포함했습니다.
3. 채택하지 않은 기법에서도 다음 답을 남겼다
채택한 기법만큼 중요했던 것은 채택하지 않은 기법입니다. 저희는 결과를 단순히 ‘효과 있음’과 ‘효과 없음’으로 나누지 않고, 현재 조건에서의 판단과 다시 확인할 조건을 함께 기록했습니다.
깨끗한 이미지를 직접 예측하면 더 잘 배울까?
플로 매칭 학습에서는 일반적으로 노이즈가 섞인 현재 상태에서 깨끗한 이미지 쪽으로 이동할 방향인 속도(velocity)를 예측합니다 (v-prediction). 반면 JiT [17]는 모델이 이동 방향 대신 깨끗한 이미지의 원본 픽셀 값을 직접 예측하도록 학습 목표를 바꿉니다(x₀-prediction).
JiT가 이러한 구성을 제안한 배경에는 픽셀 공간의 높은 차원이 있습니다. 256×256 크기의 컬러 이미지는 약 20만 개의 값으로 이루어지지만, 자연 이미지는 이 전체 공간에 고르게 분포하는 것이 아니라 일정한 구조를 가진 저차원 영역에 분포합니다. 이에 JiT는 고차원 공간 전체에 넓게 분포하는 노이즈나 속도보다, 저차원 영역에 놓인 깨끗한 이미지를 직접 예측하는 편이 더 쉽게 학습될 수 있다고 설명합니다.
저희는 먼저 기존 VAE 잠재 공간을 유지한 채 예측 방식만 JiT를 따라 x₀-prediction으로 바꿔서 비교했습니다. 그런데 VAE로 압축된 잠재 표현은 픽셀 공간과는 저차원 특성이 달라, JiT 논문이 픽셀 공간에서 보고한 것 처럼 v-prediction의 급격한 성능 저하가 관찰되지는 않았습니다. 두 방식 모두 안정적으로 학습되었으며, 오히려 v-prediction이 x₀-prediction보다 근소하게 좋은 결과를 보였습니다.
결과가 예상과 달라 VAE를 제거하고 원본 이미지를 패치로 나눈 뒤 다시 실험해보니, JiT 논문과 유사한 결과를 확인할 수 있었습니다. 이번에는 x₀-prediction이 v-prediction보다 분명히 더 좋은 성능을 보였습니다.
이 두 실험을 통해, 개별적으로 효과가 검증된 기법이라도 서로 조합했을 때 같은 효과가 유지되는 것은 아니라는 점을 다시 확인했습니다. JiT 자체는 유효한 방법이었지만, 저희의 VAE 설정과의 조합에서는 이점이 나타나지 않아 최종 레시피에서는 제외했습니다.
레지스터 토큰의 작동이 품질까지 바꾸지는 못했다
비전 트랜스포머(Vision Transformer)는 이미지를 여러 패치로 나누고, 각 패치를 토큰으로 바꿔 처리합니다. 그런데 ‘Vision Transformers Need Registers’ [18]는 정보가 적은 배경 패치에서 크기가 비정상적으로 큰 토큰(high-norm token)이 나타나는 현상을 보고했습니다.
이 토큰은 주변 이미지의 내용을 표현하기보다 모델의 내부 계산에 필요한 정보를 임시로 저장하는 공간처럼 사용됐습니다. 원래 이미지 정보를 담아야 할 토큰이 다른 역할까지 맡고 있었던 것입니다.
레지스터 토큰(register token)은 이러한 내부 계산을 전담할 별도의 학습 가능한 토큰을 추가하는 방법입니다. 이미지 토큰이 내부 정보를 저장하는 역할을 떠맡지 않게 해, 각 이미지 패치의 내용을 더 충실하게 표현하도록 돕는 것이 목적입니다.
이후 ‘F Lite Technical Report’ [19]는 이 방식을 대규모 T2I 확산 트랜스포머에 적용했습니다. 이미지 토큰 앞에 레지스터 토큰을 추가해 자기 주의(self-attention) 과정에는 함께 참여시키되, 최종 이미지 토큰 출력을 만들기 전에는 제외하는 구조입니다.
저희도 이 사례를 참고해 레지스터 토큰을 각각 8개와 16개 추가하고 기준 모델과 비교했습니다. 그 결과 새로 추가한 토큰에 실제로 주의(attention)가 집중됐습니다. 모델이 레지스터 토큰을 내부 계산 공간으로 활용한다는 작동 원리는 확인한 셈입니다.
하지만 토큰이 의도대로 작동하는 것과 생성 이미지의 품질이 좋아지는 것은 별개의 문제였습니다. 140k 스텝에서 구성 간 FID 차이는 0.059로 측정 변동 범위보다 작았고, DINO-MMD에서도 일관된 개선이 나타나지 않았습니다.
최근 연구 [20]에서도 레지스터 토큰은 픽셀 공간에서 가장 큰 개선을 보였고, VAE 잠재 공간에서는 개선 폭이 상대적으로 작았습니다. 이는 현재의 잠재 공간 실험에서 레지스터 토큰의 이점이 크지 않았던 저희 결과와 같은 방향입니다. 다만 해당 연구와 저희 실험은 모델과 학습 조건이 다르므로, 이를 결과의 직접적인 원인이라기보다 해석을 뒷받침하는 근거로 보았습니다.
학습 신호가 오래 남으면 더 좋은 표현을 배울까?
Self-Flow를 학습하면서 한 가지 현상을 발견했습니다. 학생과 교사의 표현 차이를 나타내는 정렬 손실(alignment loss)이 학습 초반에 빠르게 낮아진 뒤 거의 변하지 않았습니다.
기본 Self-Flow는 학생과 교사의 표현이 같은 방향을 가리키는지를 기준으로 두 표현을 정렬합니다. 그렇다면 손실이 너무 일찍 작아지지 않도록 정렬 방식을 바꾸면, 학습 후반까지 더 유효한 신호를 줄 수 있지 않을까요?
첫 번째로 DINO [21] 방식의 분포 정렬(distribution alignment)을 적용했습니다. 두 표현을 각각 확률 분포로 변환한 뒤, 교사와 학생의 출력 분포를 맞추는 방법입니다. 교사 모델이 만든 분포를 더 선명하게 만들어 학생이 맞혀야 할 목표도 구체화했습니다.
의도한 변화는 나타났습니다. 정렬 손실이 초반에 급격히 낮아지는 현상이 사라졌고, 학습 신호도 후반까지 유지됐습니다. 하지만 손실 곡선의 변화가 이미지 품질 개선으로 이어지지는 않았습니다.
196k 스텝에서 기본 Self-Flow와 새로운 정렬 방식의 FID 차이는 0.023에 그쳤습니다. 정성 비교에서도 어느 쪽이 더 낫다고 판단하기 어려웠고, DINO-MMD에서도 새로운 방식을 채택할 만큼 일관된 차이가 나타나지 않았습니다.
이 실험을 통해 ‘정렬 신호가 학습 후반까지 유지된다’라는 것과 ‘모델이 더 유용한 표현을 학습한다’라는 것은 서로 다른 문제라는 점을 확인했습니다. 최적화 지표가 의도대로 바뀌었다고 해서 최종 생성 품질도 반드시 좋아지는 것은 아니었습니다.
두 번째로 살펴본 iREPA [22]는 이미지 전체를 하나의 벡터로 모아 비교할 때 사라질 수 있는 공간 정보를 유지한 채 표현을 정렬하는 방법입니다. 그러나 117.6k 스텝에서 품질 차이가 뚜렷하지 않았고, 일부 구성에서는 연산 비용이 크게 증가했습니다.
현재 조건에서는 추가 구조와 연산 비용을 감수할 만큼의 이점을 확인하지 못했기 때문에 최종 레시피에는 기본 Self-Flow를 유지했습니다. iREPA는 구현 효율을 개선하거나 모델 규모와 입력 시퀀스가 커졌을 때 다시 검토할 후보로 남겼습니다.
구조를 더 키우는 것이 항상 답은 아니다
텍스트 조건을 처리하는 구조도 확장해 봤습니다. T2I 모델에서는 텍스트 인코더가 만든 표현을 이미지 생성 모델이 사용할 수 있는 형태로 바꿔 전달해야 합니다. 이 역할을 하는 모듈이 어댑터입니다.
i1 [16]은 어댑터를 단순한 다층 퍼셉트론(MLP) 대신 트랜스포머 블록으로 구성해, 텍스트 조건을 처리하는 수용력을 키우는 방법을 제안했습니다. 저희도 이 구조를 적용했지만, 현재 조건에서는 별도 모듈과 추가 연산 비용을 감수할 만큼 큰 이점을 확인하지 못했습니다. 텍스트 조건을 처리하는 수용력이 실제 성능의 병목이 되는 환경에서 다시 검토하기로 했습니다.
공유·샌드위치 정규화(shared/sandwich norm)도 비교했습니다. 결과의 변화는 크지 않았지만, 이를 근거로 정규화 기법 자체가 효과 없다고 일반화하지는 않았습니다. 원논문은 RMSNorm과의 조합을 전제로 했지만, 저희는 AdaLN을 유지한 핵심 신경망에 LayerNorm 형태로 적용했기 때문입니다. 이번 결과는 해당 기법의 일반적인 효용보다 현재 조합에서의 우선순위가 낮다는 의미로 해석했습니다.
그 밖에도 텍스트 토큰과 이미지 토큰을 따로 처리하는 블록과 함께 처리하는 블록의 비율을 바꿔봤습니다. 서로 다른 설명문이 만드는 이미지 생성 경로를 더 강하게 분리하는 Contrastive Flow Matching [23]도 비교했습니다.
일부 구성은 이미지 분포가 좋아지는 대신 프롬프트를 반영하는 텍스트 정렬 성능이 낮아졌습니다. 또 다른 구성은 평가 지표의 변화보다 모델 구조와 연산 비용이 더 크게 늘었습니다. 한 지표의 개선만으로 기법을 선택하지 않고, 이미지 품질과 텍스트 반영 능력, 연산 비용을 함께 고려했습니다.
이 실험들은 단순한 실패 목록이 아니었습니다. 레지스터 토큰처럼 작동 원리는 확인됐지만 품질 개선으로 이어지지 않은 경우가 있었고, DINO 방식의 정렬처럼 학습 신호는 바뀌었지만 최종 결과가 달라지지 않은 경우도 있었습니다. JiT처럼 모델의 표현 공간과 예측 대상을 바꿔 원 논문의 핵심 구성을 검증했지만, 저희 실험 조건에서는 최종 레시피에 포함할 만큼 뚜렷한 이점이 나타나지 않은 사례도 있었습니다.
덕분에 무엇을 채택하지 않을지 뿐만 아니라 왜 채택하지 않았는지, 어떤 조건에서 다시 확인해야 하는지도 함께 남길 수 있었습니다. 이러한 기록은 다음 모델에서 같은 실험을 처음부터 반복하지 않고, 조건에 맞는 후보를 빠르게 고르는 기준이 됩니다.
4. 좋은 선택을 모으면 좋은 레시피가 될까?
개별 제거 실험(ablation)에서 효과가 있었던 기법을 모두 합친다고 최종 레시피가 완성되는 것은 아닙니다. 각각은 단독으로 적용했을 때 좋은 결과를 냈지만, 여러 기법을 함께 사용하면 효과가 겹치거나 서로 간섭할 수 있습니다.
한 요소가 바뀌면서 다른 설정의 적정 값도 달라질 수 있습니다. 예를 들어 VAE나 이미지 해상도를 바꾸면 데이터의 형태와 통계가 달라지고, 이에 맞춰 노이즈 이동 값도 다시 조정해야 합니다.
따라서 저희는 개별 실험의 결과를 단순히 합산하지 않았습니다. 효과를 확인한 기법을 하나씩 추가하고, 조합한 상태에서도 각 선택의 이점이 유지되는지 다시 확인했습니다.
먼저 같은 T2I 설정에서 FLUX.2 VAE와 Muon을 차례로 적용하고, 두 구성이 공통으로 도달한 42k 스텝에서 비교했습니다. Self-Flow는 짧은 실험에서 DINO-MMD가 먼저 개선됐지만 FID 차이는 분명하지 않았습니다. 이에 따라 FLUX.2 VAE를 사용하는 두 구성을 196k 스텝까지 학습한 뒤 다시 판단했습니다.
아래 표는 정량 비교가 가능한 세 가지 기법을 추가하기 전후의 변화를 보여줍니다. 서로 다른 학습 스텝 수에서 측정한 수치를 직접 합치지 않고, 각 실험에서 변경 전과 변경 후가 모두 도달한 공통 스텝 수를 기준으로 비교했습니다.
| 단일 변경 | 공통 스텝 수 | FID-5k (변경 전 → 후) ↓ | DINO-MMD (변경 전 → 후) ↓ |
|---|---|---|---|
| (a): FLUX.1 VAE → FLUX.2 VAE | 42k | 35.12 → 13.19 | 37.77 → 11.05 |
| (b): (a) + AdamW → Muon | 42k | 13.19 → 12.07 | 11.05 → 7.96 |
| (c): (b) + Self-Flow | 196k | 11.30 → 11.27 | 4.46 → 3.91 |
두 번째 통합 재검증에서는 VLM의 여러 중간 계층을 사용하는 공통 설정에서 롱 스킵만 추가해 비교했습니다. 117.6k 스텝에서 FID는 11.11에서 10.81로, DINO-MMD는 6.30에서 4.53으로 낮아졌습니다. 앞선 통합 재검증에서 선택한 기법과 텍스트 조건을 함께 적용한 상태에서도 롱 스킵의 이점이 유지됐습니다. 각 통합 재검증에서 얻은 결과를 하나의 종합 수치로 합치기보다, 기법을 조합한 뒤에도 새로 추가한 선택의 효과가 유지되는지를 차례로 확인했습니다. 노이즈 이동 값은 학습과 생성에서 각각 조정했고, 텍스트 조건은 일반 T2I 지표와 텍스트 렌더링 결과를 함께 보며 선택했습니다.
최종적으로 생성에 적합한 잠재 표현, 데이터 통계에 맞춘 노이즈 이동 값, Muon, Self-Flow, 롱 스킵, VLM의 여러 중간 계층을 활용한 텍스트 조건을 하나의 학습 레시피로 구성했습니다.
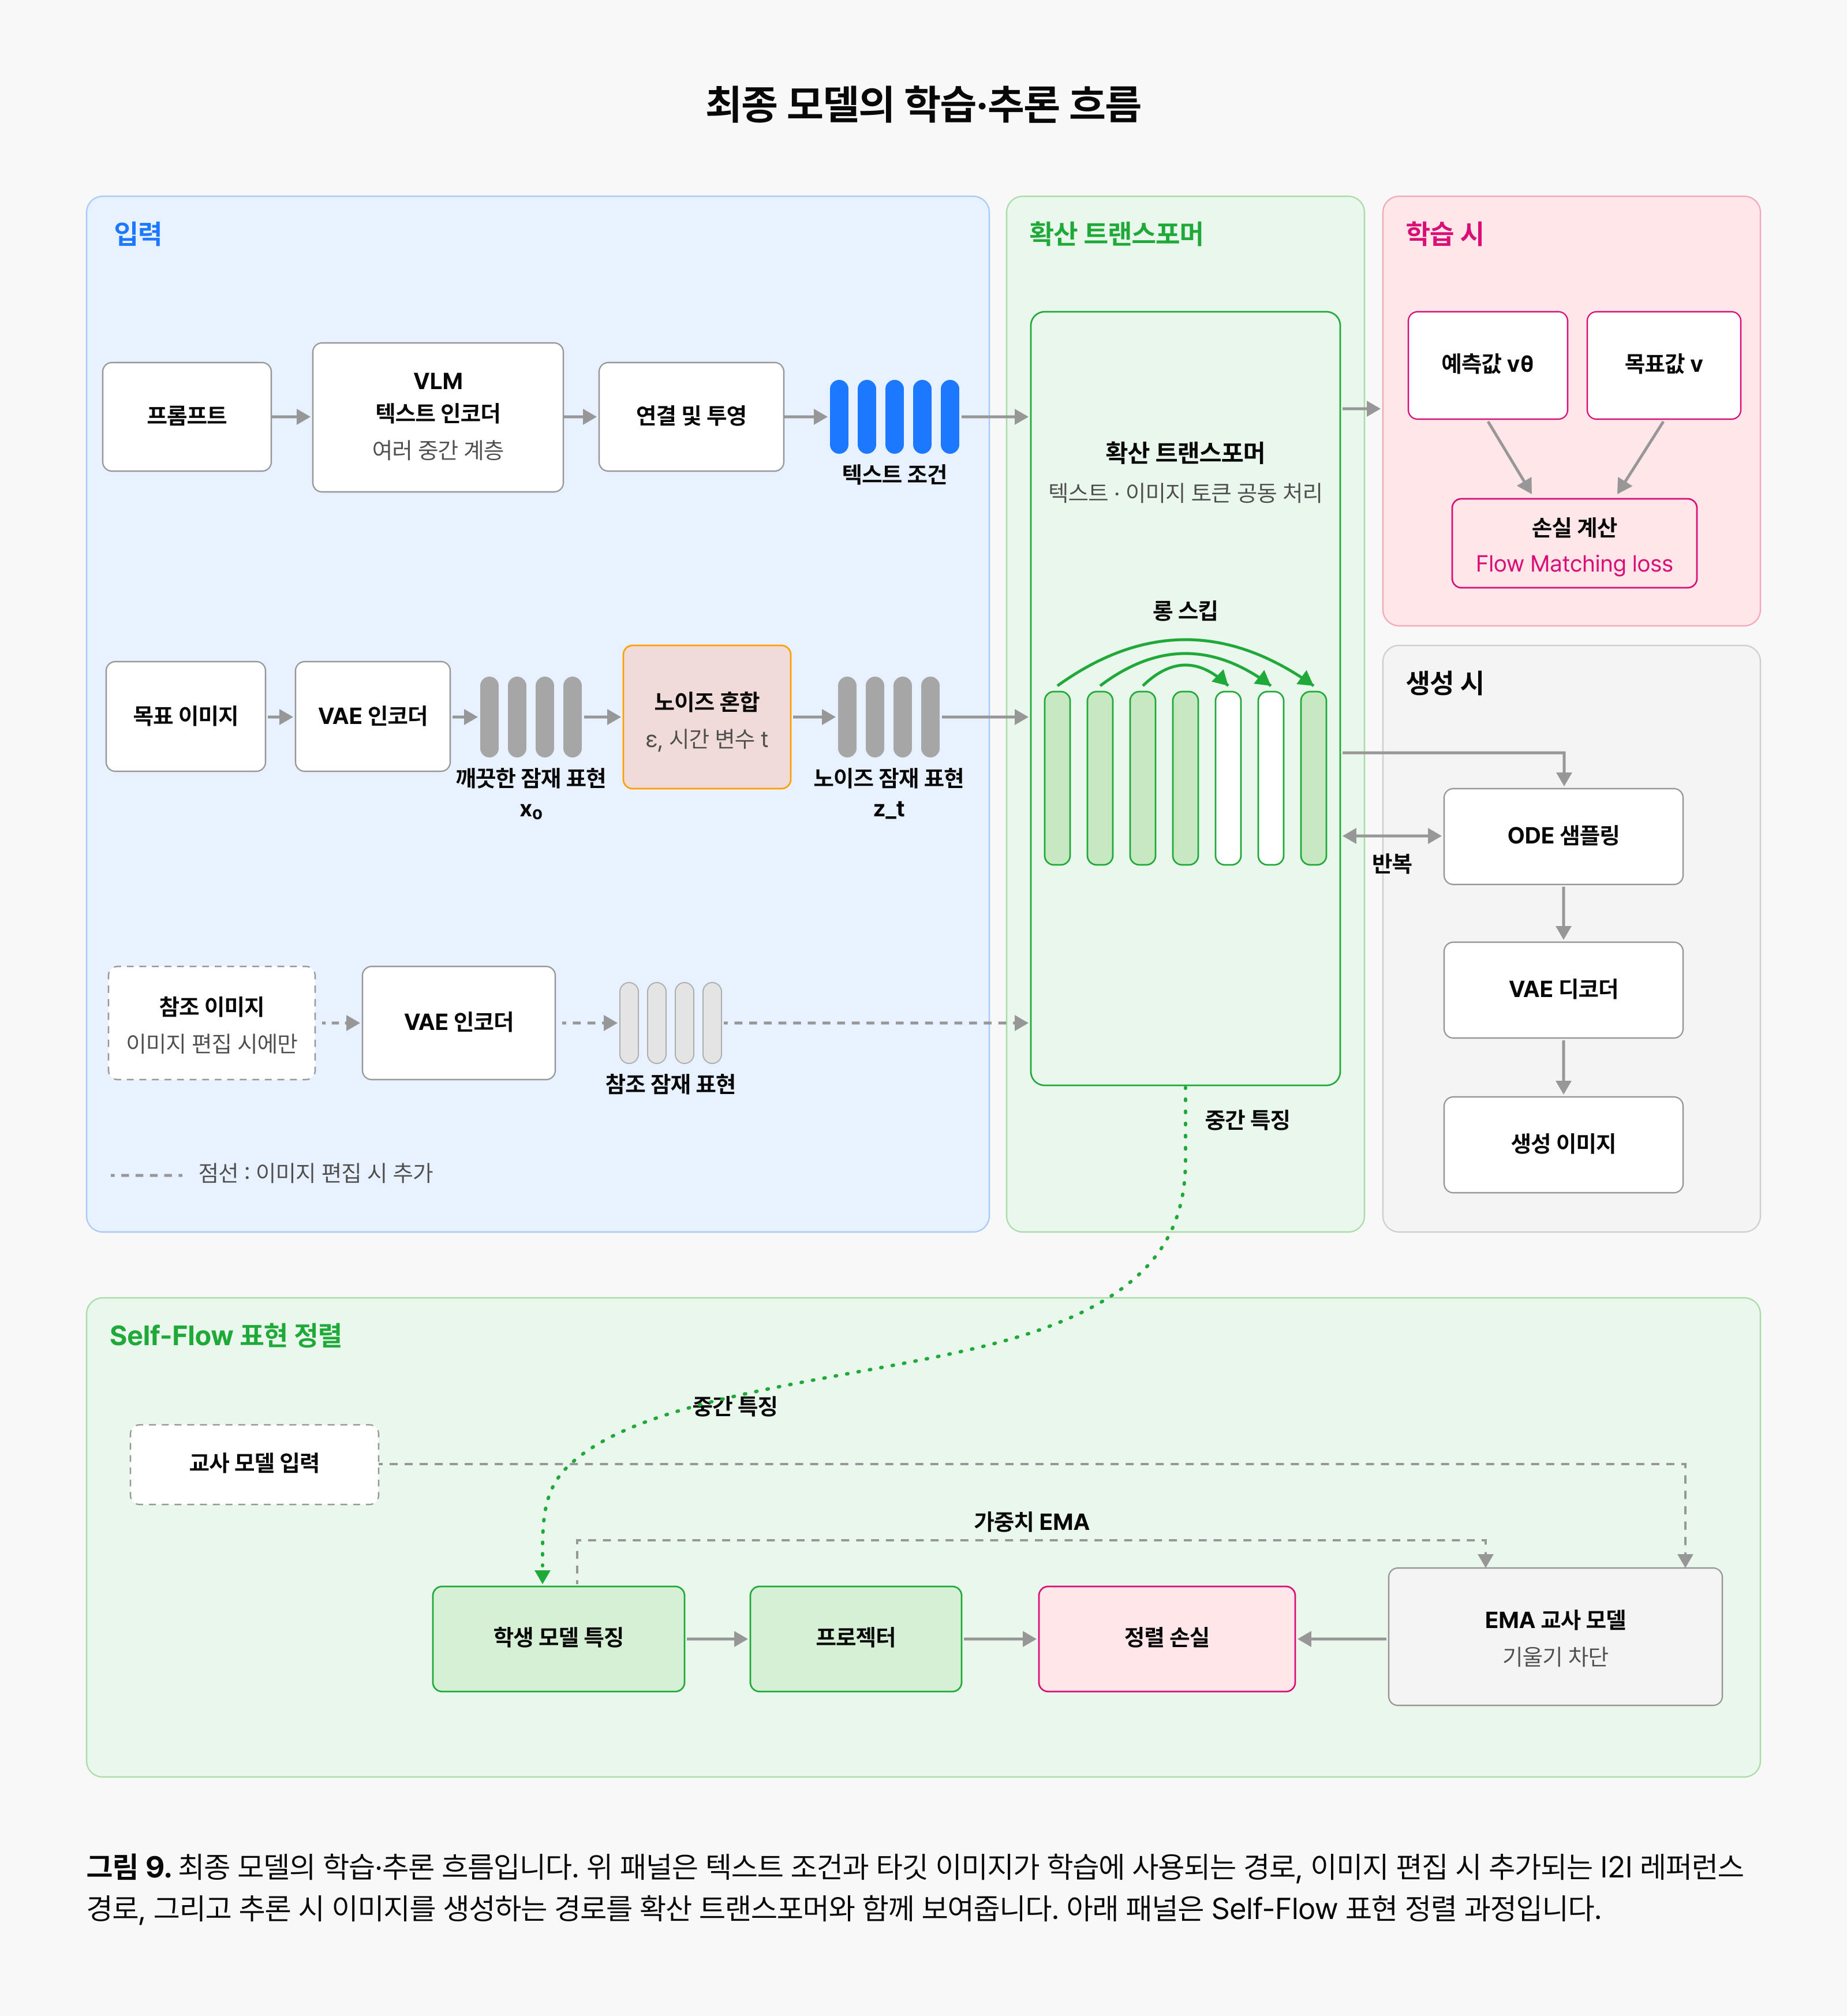
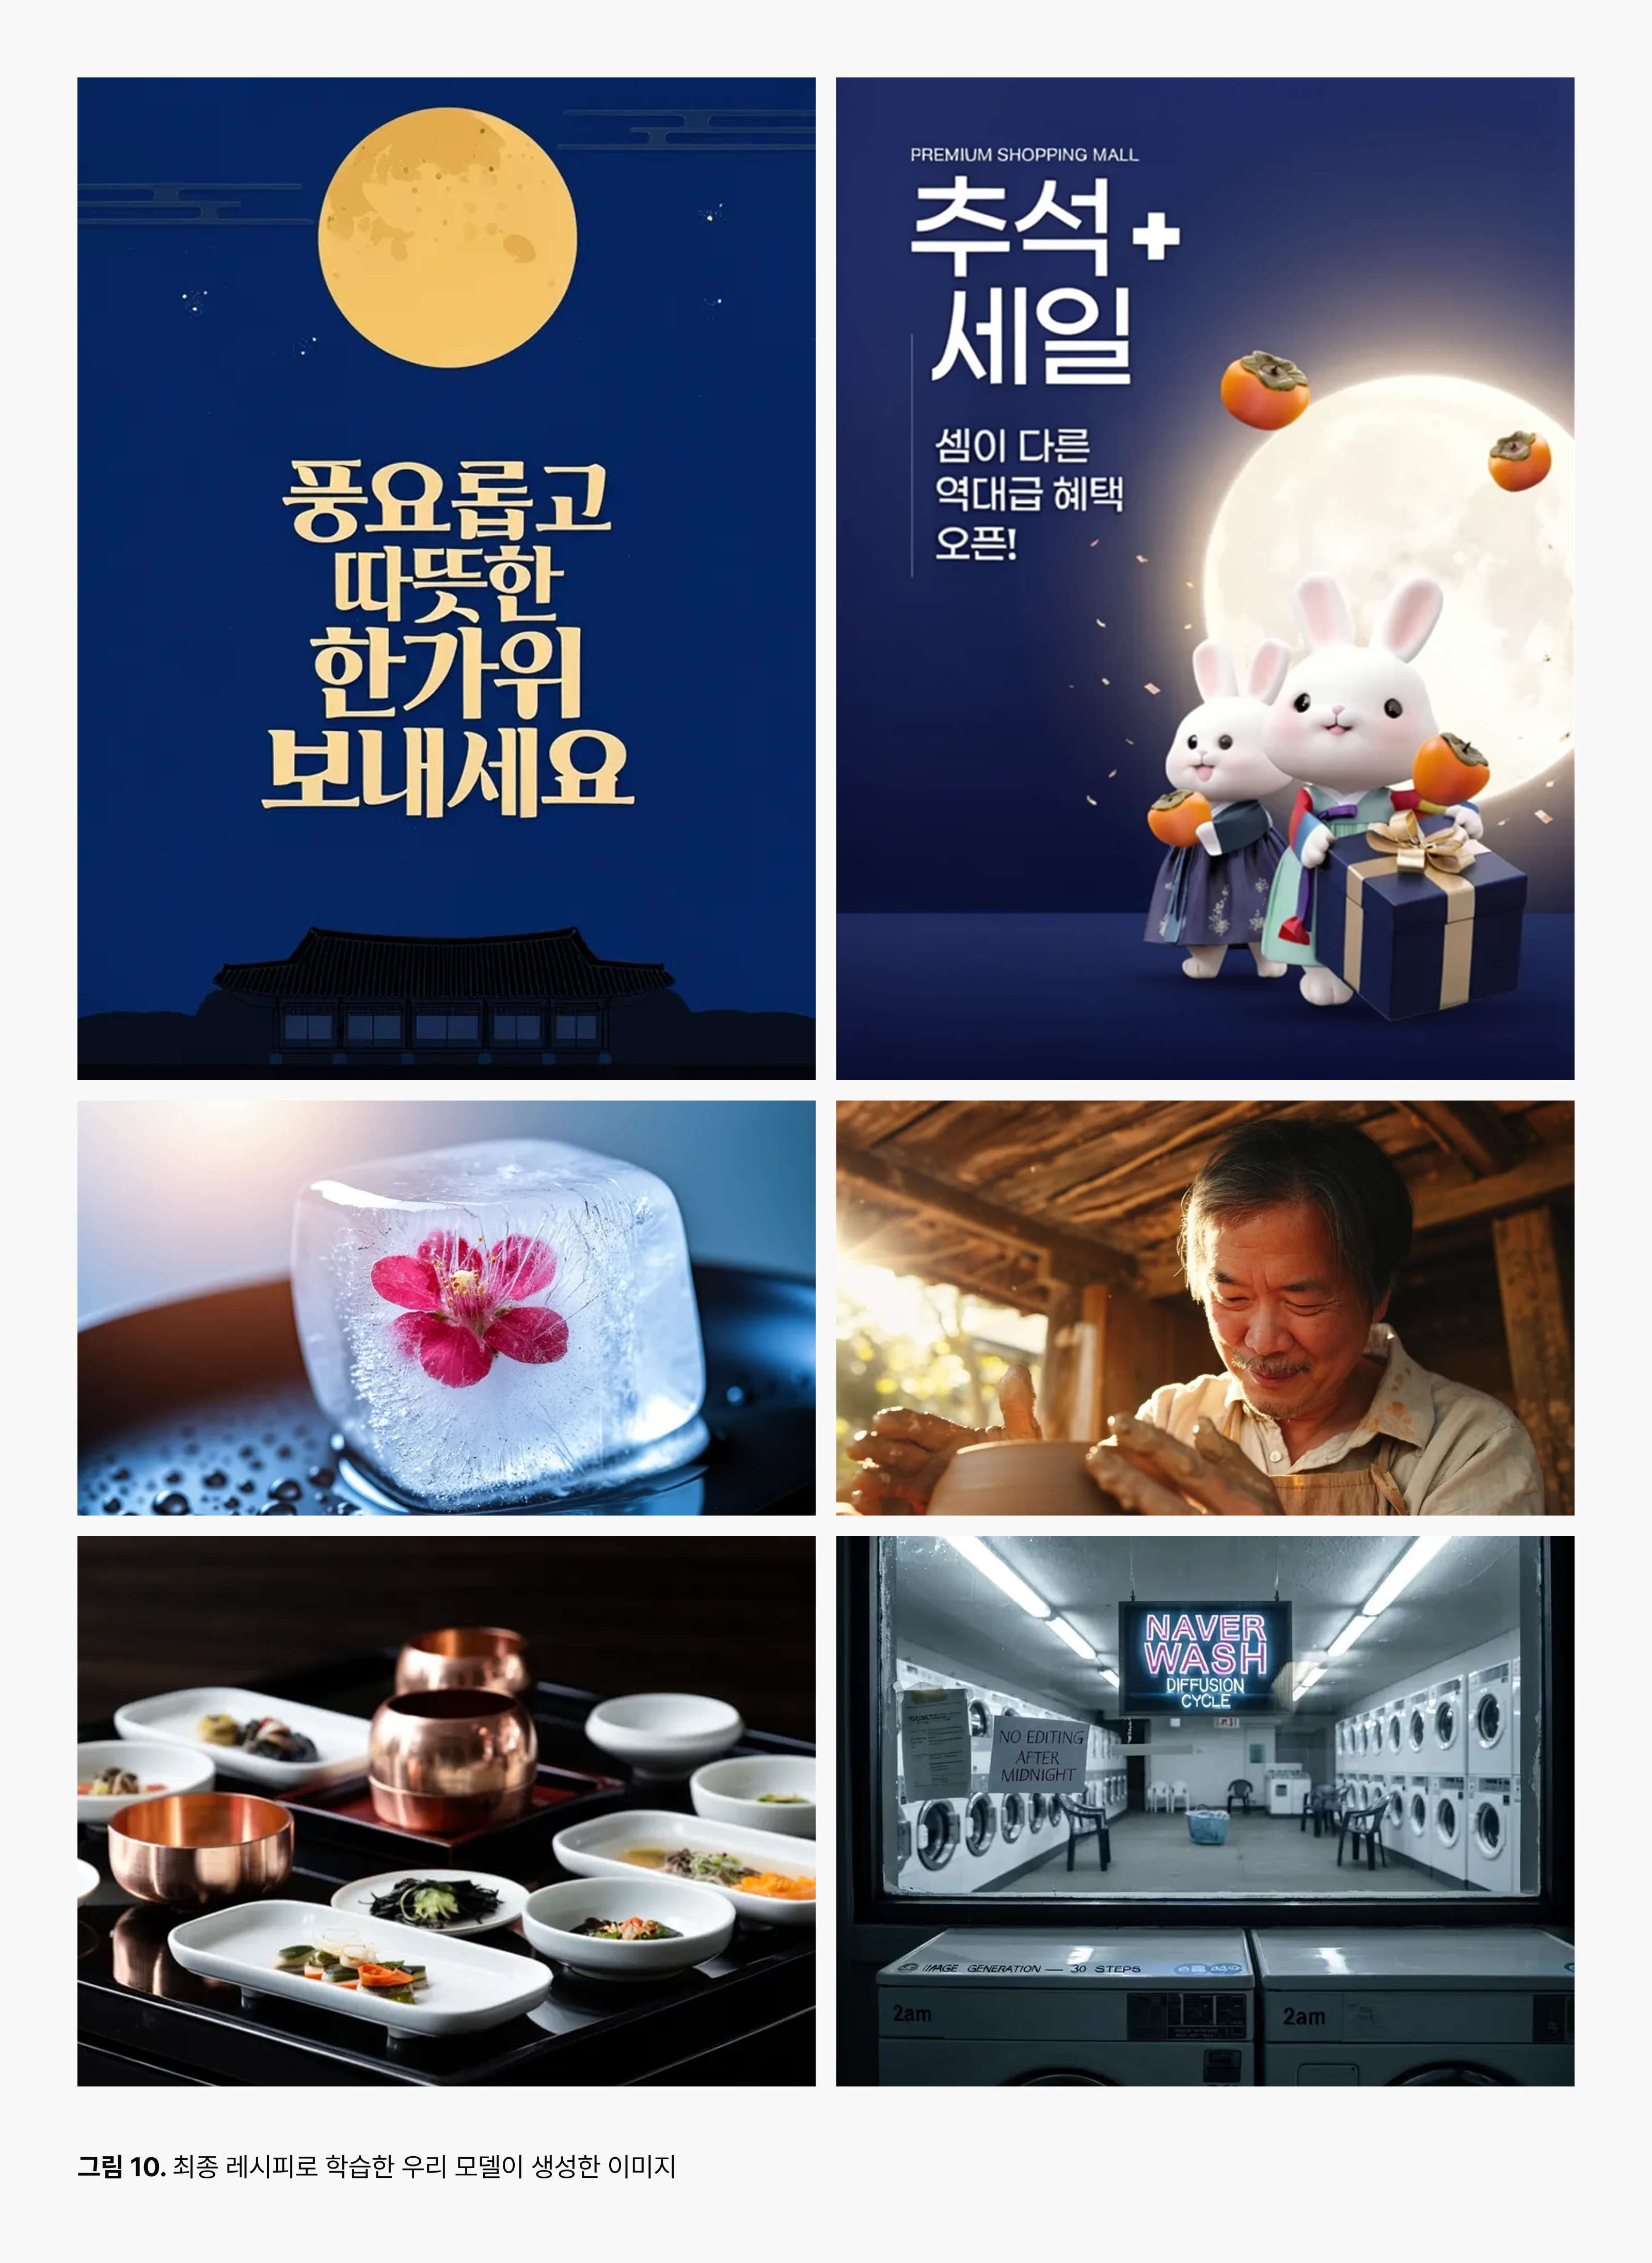
그 결과 일반적인 이미지 생성뿐 아니라 복잡한 서술형 프롬프트를 따르는 능력과 한국어·영어 텍스트 렌더링에서도 가능성을 확인했습니다. 처음 목표였던 이미지 편집으로도 확장해, 원본의 맥락을 유지하면서 지시한 부분을 바꾸는 기반을 마련했습니다.
다만 모델 구조 탐색만으로 해결되지 않는 영역도 있습니다. 사람의 미적 선호와 세부 질감은 데이터 구성과 사후 학습(post-training)의 영향을 크게 받습니다. 저희는 이 영역을 이번 글에서 다룬 구조 탐색과 구분해 개선하고 있습니다. 생성 결과에 대한 사람의 선호를 보상(reward)으로 정의하는 강화학습(reinforcement learning, RL)을 포함한 후속 학습을 통해 실제 사용자가 체감하는 품질을 높이고 있습니다.
5. 연구 성과를 넘어 서비스에
연구 결과를 바탕으로 실제 네이버 서비스로 연결하기 위한 준비도 이어가고 있습니다. 업무 문서나 발표 자료에 필요한 이미지를 만들고 원하는 부분만 수정하는 기능부터, 배경과 문구를 바꿔 여러 광고 소재를 빠르게 제작하는 기능까지 활용 범위를 검토하고 있습니다.
실제 서비스에서는 그럴듯한 이미지 한 장을 만드는 능력만으로 충분하지 않습니다. 사용자의 지시를 정확히 이해하고, 원본에서 유지해야 할 부분과 바꿔야 할 부분을 구분해야 합니다. 같은 요청을 반복하더라도 일정한 품질을 유지하는 능력도 필요합니다.
특히 기업이나 공공기관처럼 정확성과 일관성이 중요한 환경에서는 이러한 조건이 모델에 대한 신뢰와 직결됩니다. 결과가 사용자의 의도를 안정적으로 반영하고, 실제 업무 과정에서 반복적으로 활용할 수 있어야 하기 때문입니다.
네이버클라우드는 모델의 생성 품질뿐 아니라 지시 이해와 편집 일관성까지 함께 개선해, 이번 연구에서 확보한 기술 기반을 실제 네이버 서비스 경험으로 연결해 나가고자 합니다.
6. 맺으며
이번 작업에서 얻은 가장 큰 결과는 특정 모델에만 적용되는 설정 목록이 아니었습니다. 새로운 후보를 빠르게 검증하고, 현재 조건에 맞는 선택을 찾아가는 반복 가능한 탐색 방법이었습니다.
저희는 빠르게 변하는 연구 흐름 속에서 가능성이 있는 기법을 선별하고, 작은 모델에서 한 번에 한 가지 요소만 바꿔 실험했습니다. 학습 스텝 수뿐 아니라 실제 경과 시간을 비교했고, FID 하나에만 의존하지 않고 여러 정량 지표와 생성 이미지를 함께 살펴봤습니다.
차이가 분명하지 않은 실험도 버리지 않았습니다. 현재 조건에서 채택하지 않은 이유와 다시 확인해야 할 조건을 함께 기록했습니다. 덕분에 새로운 기술을 무조건 추가하기보다, 현재 모델에서 실제로 효과가 남는 선택에 집중할 수 있었습니다.
최종 레시피에는 문헌 검토나 사전 논의에서 예상했던 것과 다른 선택도 적지 않았습니다. 모델의 구조를 복잡하게 만드는 것보다 잠재 표현과 최적화 알고리즘, 데이터에 맞춘 학습 설정이 더 큰 차이를 만든 경우도 있었습니다. 논문에서 좋은 결과를 낸 기법도 모델 크기와 해상도, 학습 공간이 달라지면 우선순위가 달라졌습니다.
평가 방법도 하나로는 충분하지 않았습니다. FID에서 잘 드러나지 않은 차이는 DINO-MMD와 텍스트 렌더링에서 확인할 수 있었습니다. 정량 지표가 놓치는 글자와 손가락, 반복 무늬 같은 세부는 같은 프롬프트로 생성한 이미지를 직접 비교해 살펴봤습니다.
“한옥을 배경으로, 두 사람은 커피를 들고 남자는 선글라스를 쓰도록 바꿔줘.”
이 지시대로 이미지를 편집하려면 모델은 무엇부터 배워야 할까요?
이러한 편집 능력은 비슷한 편집 데이터만 학습한다고 갖춰지는 것이 아닙니다. 이미지를 효과적으로 표현하는 잠재 공간과 복잡한 지시를 이해하는 텍스트 조건, 제한된 시간 안에 충분히 학습할 수 있는 구조가 먼저 갖춰져야 합니다.
네이버클라우드는 이 기반 위에서 한국어 지시를 정확히 이해하고, 한국 사용자에게 익숙한 시각적 맥락을 자연스럽게 표현하는 이미지 생성·편집 모델로 나아가고자 합니다.
한국어로 묘사한 복잡한 장면을 의도대로 그리고, 포스터 안의 문구를 정확하게 표현하며, 배경과 소품, 인물의 속성을 지시에 맞게 한 번에 반영하면서도 장면 전체를 자연스럽게 유지하는 것. 이러한 생성과 편집이 특별한 기능이 아니라 누구나 신뢰하고 활용할 수 있는 도구가 될 때까지, 더 나은 구조와 학습 방법을 계속 탐색하겠습니다.
참고 문헌 및 공개 구현
[1] Martin Heusel et al., “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” NeurIPS 2017. https://arxiv.org/abs/1706.08500 · FID code: https://github.com/bioinf-jku/TTUR
[2] Maxime Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision,” TMLR 2024. https://arxiv.org/abs/2304.07193 · Code: https://github.com/facebookresearch/dinov2
[3] PhotoRoom, “PRX: An Open-Source Text-to-Image Model,” DINO-MMD를 포함한 evaluation implementation, 2026. https://github.com/Photoroom/PRX
[4] Alec Radford et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML 2021. https://arxiv.org/abs/2103.00020 · Code: https://github.com/openai/CLIP
[5] Christoph Schuhmann, “CLIP+MLP Aesthetic Score Predictor (LAION Aesthetic Predictor V2),” 2022. https://github.com/christophschuhmann/improved-aesthetic-predictor
[6] Black Forest Labs, “FLUX.2: Analyzing and Enhancing the Latent Space of FLUX — Representation Comparison,” 2025. https://bfl.ai/research/representation-comparison
[7] Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR 2019. https://arxiv.org/abs/1711.05101 · Code: https://github.com/loshchil/AdamW-and-SGDW
[8] Keller Jordan et al., “Muon: An Optimizer for Hidden Layers in Neural Networks,” 2024. https://kellerjordan.github.io/posts/muon/ · Code: https://github.com/KellerJordan/Muon
[9] Yaron Lipman et al., “Flow Matching for Generative Modeling,” ICLR 2023. https://arxiv.org/abs/2210.02747
[10] Alexey Dosovitskiy and Thomas Brox, “Generating Images with Perceptual Similarity Metrics based on Deep Networks,” NeurIPS 2016. https://arxiv.org/abs/1602.02644
[11] Tim Salimans et al., “Improved Techniques for Training GANs,” NeurIPS 2016. https://arxiv.org/abs/1606.03498
[12] Sihyun Yu et al., “Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think,” ICLR 2025. https://arxiv.org/abs/2410.06940
[13] Hila Chefer et al., “Self-Supervised Flow Matching for Scalable Multi-Modal Synthesis,” 2026. https://arxiv.org/abs/2603.06507 · Code: https://github.com/black-forest-labs/Self-Flow
[14] Olaf Ronneberger, Philipp Fischer, and Thomas Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” MICCAI 2015. https://arxiv.org/abs/1505.04597
[15] Fan Bao et al., “All are Worth Words: A ViT Backbone for Diffusion Models,” CVPR 2023. https://arxiv.org/abs/2209.12152 · Code: https://github.com/baofff/U-ViT
[16] Boya Zeng et al., “i1: A Simple and Fully Open Recipe for Strong Text-to-Image Models,” 2026. https://arxiv.org/abs/2606.11289 · Code: https://github.com/zlab-princeton/i1
[17] Tianhong Li and Kaiming He, “Back to Basics: Let Denoising Generative Models Denoise,” 2025. https://arxiv.org/abs/2511.13720
[18] Timothée Darcet et al., “Vision Transformers Need Registers,” ICLR 2024. https://arxiv.org/abs/2309.16588
[19] Simo Ryu, Lu Pengqi, Javier Martín Juan, and Iván de Prado Alonso, “F Lite Technical Report,” 2025. https://github.com/fal-ai/f-lite/blob/main/assets/F%20Lite%20Technical%20Report.pdf · Code: https://github.com/fal-ai/f-lite
[20] Nikita Starodubcev et al., “Registers Matter for Pixel-Space Diffusion Transformers,” 2026. https://arxiv.org/abs/2605.16147
[21] Mathilde Caron et al., “Emerging Properties in Self-Supervised Vision Transformers,” ICCV 2021. https://arxiv.org/abs/2104.14294
[22] Jaskirat Singh et al., “What Matters for Representation Alignment: Global Information or Spatial Structure?,” 2025. https://arxiv.org/abs/2512.10794 · Code: https://github.com/end2end-diffusion/irepa
[23] George Stoica et al., “Contrastive Flow Matching,” ICCV 2025. https://arxiv.org/abs/2506.05350 · Code: https://github.com/gstoica27/DeltaFM